Alibaba Cloud a annoncé sa première région sud-américaine le 27 août, avec deux datacenters au Brésil. Cette infrastructure locale ajoute une option de déploiement, sans prouver à elle seule la disponibilité ou la résilience de votre application précise.
Infrastructure ouverte et services encore prévus
Le communiqué brésilien présente l’ouverture et des projets d’introduction de services d’agents pour les entreprises. Tous ces services futurs ne doivent pas être décrits comme disponibles au lancement. Le texte donne 106 zones de disponibilité dans 31 régions mondiales : ce sont les chiffres du fournisseur au moment de l’annonce.
Une catégorie de produits n’est pas une configuration de serveur. Vérifiez famille d’instances, version de base gérée, quotas et endpoints régionaux avant une migration. Suivez aussi les destinations des sauvegardes, de la supervision et des API externes : installer l’application au Brésil ne prouve pas que toutes ses dépendances y résident.
Deux zones imposent un scénario de panne précis
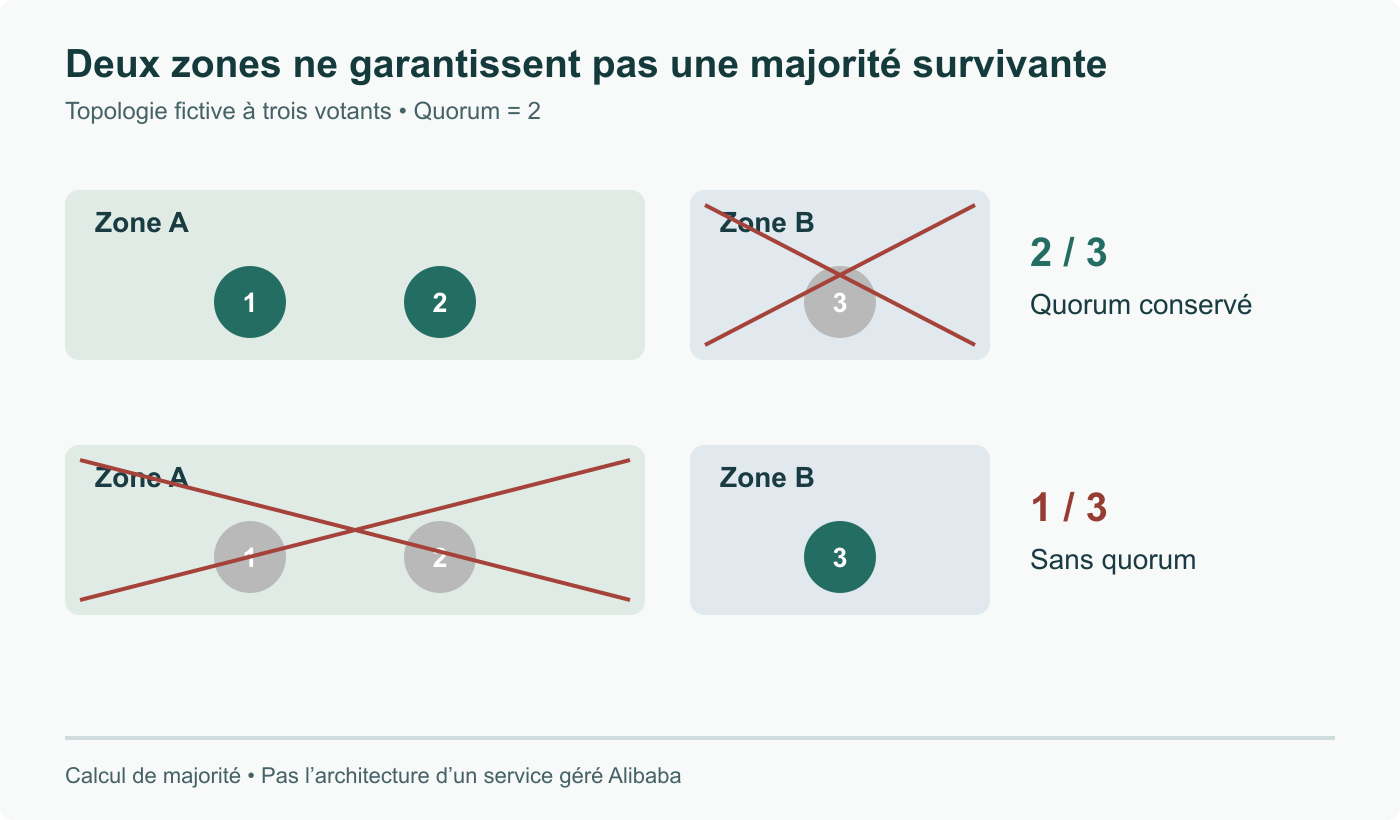
Notre explication précédente laissait croire qu’un système à quorum exige simplement un nombre impair de domaines de panne. La majorité dépend des membres votants et de leur placement, pas du caractère impair du nombre de zones.
La FAQ d’etcd explique qu’une majorité est nécessaire pour progresser. Exemple à trois votants : deux en zone A, un en B. Perdre B laisse deux votants et une majorité ; perdre A laisse un seul votant. Le schéma illustre ce calcul, pas l’architecture d’une base gérée Alibaba.
Quatre votants répartis deux par zone ne résolvent pas ce problème : chaque perte de zone laisse deux membres, sous les trois requis. Un troisième domaine indépendant peut aider, mais latence distante, pannes corrélées et topologie officiellement prise en charge restent à considérer. N’improvisez pas une configuration de témoin non supportée par la base.
Mesurer le chemin suivi par vos utilisateurs
Testez depuis les villes et réseaux d’accès qui fournissent votre trafic réel. Relevez connexion, réponse applicative complète et taux d’erreur à plusieurs horaires. Comparez le même traitement, pas un ping chez un fournisseur avec une requête de base chez un autre. Une région proche réduit parfois la distance sans éliminer un mauvais routage ou un backend distant.
Pour la résilience, arrêtez volontairement une réplique jetable et observez quelles opérations restent disponibles. Testez ensuite une restauration depuis une sauvegarde distincte. Réussir face à une réplique arrêtée ne prouve pas la survie à une panne de zone entière ; nommez chaque résultat d’après le défaut effectivement exercé. Nous n’avons ni provisionné ni benchmarké cette région.
Sources
Communiqué brésilien vérifié ; date corrigée au 27 août, services d’agents prévus distingués de la disponibilité initiale et raisonnement sur le quorum corrigé.