Gemini 3.7 Flash est arrivé avec un prix introductif limité dans le temps. Le budget doit séparer les périodes, et l’article actualisé doit aussi signaler la sortie ultérieure de 3.8.
Conserver un historique clair
Google a présenté 3.7 Flash le 13 août, en citant retours des développeurs et progrès algorithmiques. Le court intervalle entre versions ne prouve pas une méthode d’entraînement précise ; l’affirmation initiale sur ce qui ne pouvait pas avoir été préentraîné est retirée.
Google a ensuite annoncé 3.8 Flash le 2 septembre. Cette page conserve l’événement 3.7. Une nouvelle version mérite une évaluation sans prouver que votre intégration a déjà changé.
Deux périodes tarifaires
Le barème Gemini API actuel affiche, en standard 3.7, 0,75 $ en entrée et 3,75 $ en sortie, raisonnement compris, par million de tokens jusqu’au 31 décembre. Les prix prévus au 1er janvier sont 1,50 $ et 7,50 $. Stockage du cache, entrées en cache, recherche et niveaux de service ont d’autres lignes.
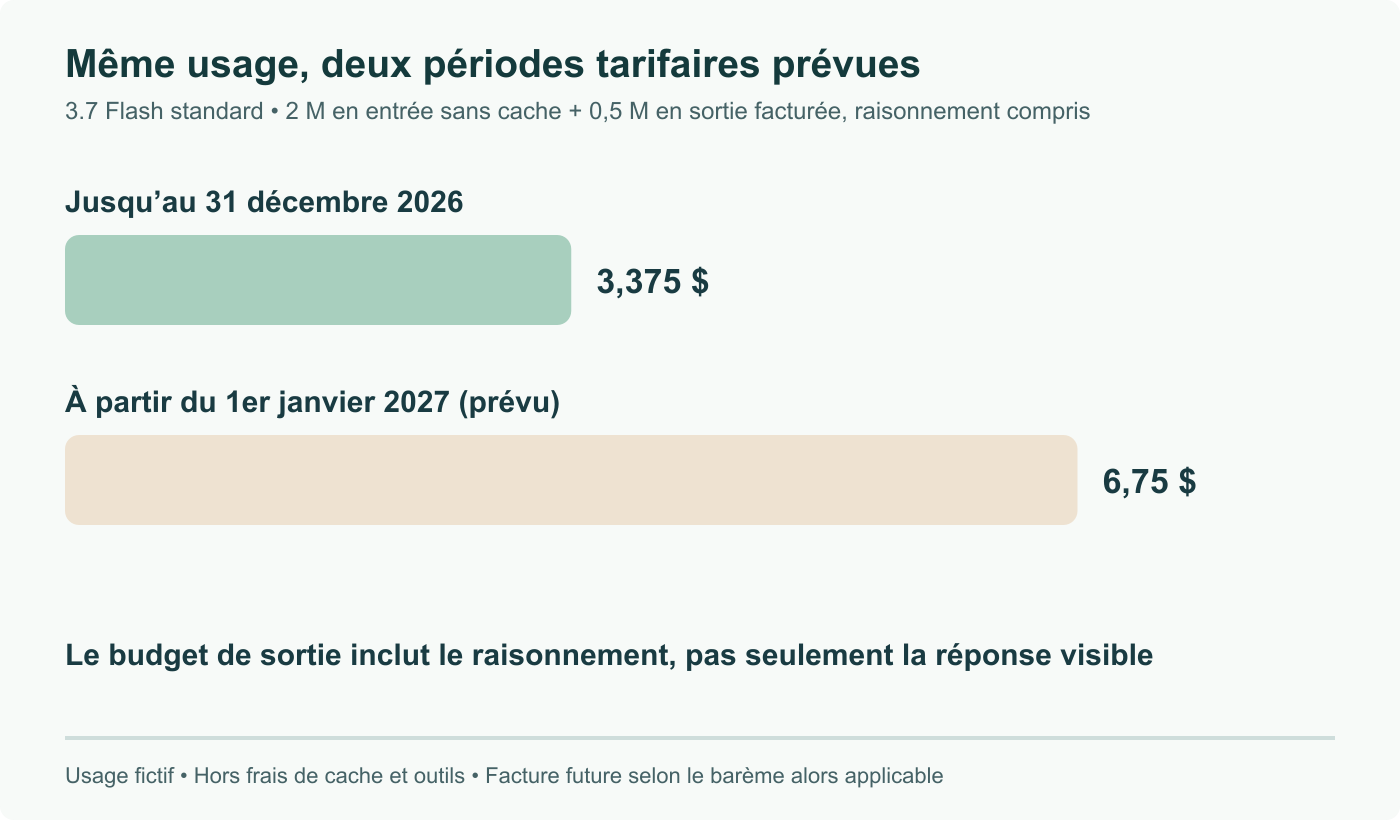
Pour deux millions de tokens d’entrée sans cache et un demi-million de sortie totale facturée, le coût illustratif actuel est 3,375 $, contre 6,75 $ au tarif standard prévu. L’exemple exclut cache et outils et suppose un usage identique. La facture future dépendra toujours du barème alors applicable.
Compter ce qui est facturé
Un demi-million de tokens de réponses visibles n’est pas nécessairement un demi-million de sortie facturée si le raisonnement s’ajoute. Relevez les catégories d’usage retournées plutôt que d’estimer seulement le texte affiché. Tentatives répétées et raisonnement long peuvent peser plus qu’un petit écart tarifaire.
La documentation 3.7 distingue aussi limites d’entrée et de sortie. Une grande fenêtre d’entrée ne garantit pas de reproduire tout le document dans une seule réponse. Concevez la tâche autour du résultat attendu et vérifiez les conditions d’arrêt ou de troncature.
Pour essayer 3.8, gardez les mêmes tâches, permissions d’outils et critères de réussite. Comparez coût par tâche terminée, latence et erreurs, pas seulement rang de benchmark ou prix du token. Enregistrez l’identifiant du modèle et le comportement des alias : un nom ressemblant à une version ne prouve pas que tous les détails du service sont immuables.
Revue du 8 septembre : sources primaires relues, données et statut actualisés, affirmations excessives retirées ; exemple explicatif original.