La proposition du 26 août évitant les sondages BMI2 répétés a évolué le 30 août. Elle utilise désormais directement les mécanismes x86 du noyau. Le gain rapporté concerne de petites opérations dans une VM KVM à un seul vCPU.
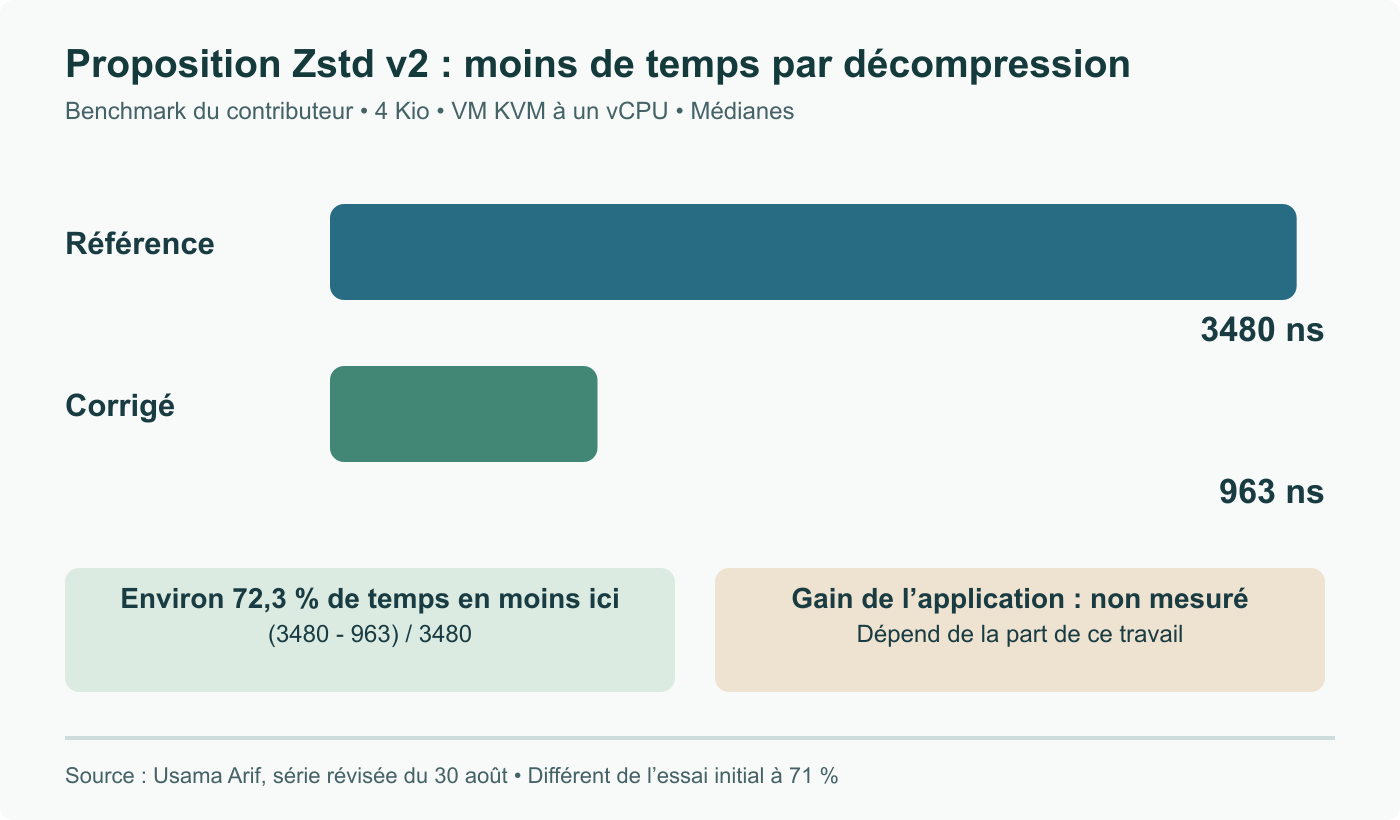
La proposition a changé après relecture
La série initiale proposait de mémoriser la réponse sur les capacités CPU. La série révisée emploie cpu_feature_enabled(X86_FEATURE_BMI2) dans les compilations ordinaires du noyau. Elle évite le sondage CPUID privé et confie la sélection au mécanisme existant du noyau.
Bibliothèque autonome et décompresseur de prédémarrage ont des contraintes différentes ; la proposition conserve leurs chemins séparés. Dire que toutes les copies de Zstd détectent désormais le CPU une seule fois de la même façon serait inexact. Cet article décrit la révision publiée, sans établir sa livraison dans un paquet de distribution.
Ce que mesure le pourcentage
Le contributeur décrit un test crypto_acomp de 4 Kio dans une VM KVM à un vCPU. Dans la mesure révisée, la médiane de décompression passe de 3 480 ns à 963 ns, soit environ 72,3 % de durée en moins. La série initiale donnait environ 71 % sur une autre mesure ; il ne faut pas fusionner ces deux essais.
Il s’agit d’une optimisation des coûts périphériques : l’auteur désigne les sorties de VM provoquées par CPUID comme particulièrement coûteuses dans l’invité. Cela ne démontre ni un changement de format de compression, ni une accélération de 72 % de toutes les archives.
Durée et débit n’utilisent pas le même dénominateur
La réduction calculée vaut (3480 - 963) / 3480. Sous l’hypothèse supplémentaire d’opérations identiques et séquentielles, sans autre limite, l’inverse du temps suggère 3480 / 963, soit environ 3,61 fois plus d’opérations par seconde. Ce ratio dérivé n’est pas un débit applicatif mesuré de bout en bout.
Prenons un exemple applicatif original où le travail ciblé occupe seulement 10 % de la durée initiale. Réduire cette partie à 27,7 % de sa durée laisse 90 % + 2,77 % = 92,77 % au total : environ 7,23 % de temps économisé, avec un travail séquentiel et des autres coûts inchangés.
Gros blocs, exécution native, contextes réutilisés et traitements limités par le stockage peuvent présenter d’autres proportions. Une évaluation locale utile conserve taille des blocs, cycle de vie des contextes et réglages de virtualisation avec les résultats. Reproduire le chemin réel de l’application compte davantage que reprendre le plus grand pourcentage du courriel.
Revue du 8 septembre : sources et suites de l’annonce vérifiées, explications et illustration reprises.