Ultrafast accélère un chemin d’exécution du modèle. L’application attend encore recherche, outils et services externes : son gain dépend de la part de délai réellement occupée par l’inférence.
La promesse de l’avant-première
L’annonce OpenAI du 13 août présente GPT-5.6 Sol dans une nouvelle offre, jusqu’à 750 tokens de sortie par seconde et 14× la vitesse du traitement Standard. Elle décrit une avant-première API limitée, élargie selon la capacité. Ce sont des maxima annoncés, pas une latence garantie ou un prix public.
Cela concerne Sol, sans établir les mêmes performances pour les modèles OpenAI ultérieurs. Une offre API n’implique pas non plus son accès dans chaque abonnement ChatGPT.
Identifier le comparateur
Le récit technique Cerebras décrit des couches réparties en pipeline sur plusieurs wafers, avec SRAM intégrée. L’ancien texte pouvait laisser croire que tout le modèle tenait dans une seule puce de 44 Go ; cette architecture multi-wafer ne l’établit pas.
Cerebras rapporte 5,6× sur GDP-Val entre Sol et Sol Ultrafast. Son chronométrage HLE compare Sol Ultrafast à Claude Fable 5 avec des agents différents. Ce sont des protocoles distincts, menés par le fournisseur ; HLE ne doit pas devenir un essai Standard contre Ultrafast.
Le gain d’une tâche complète
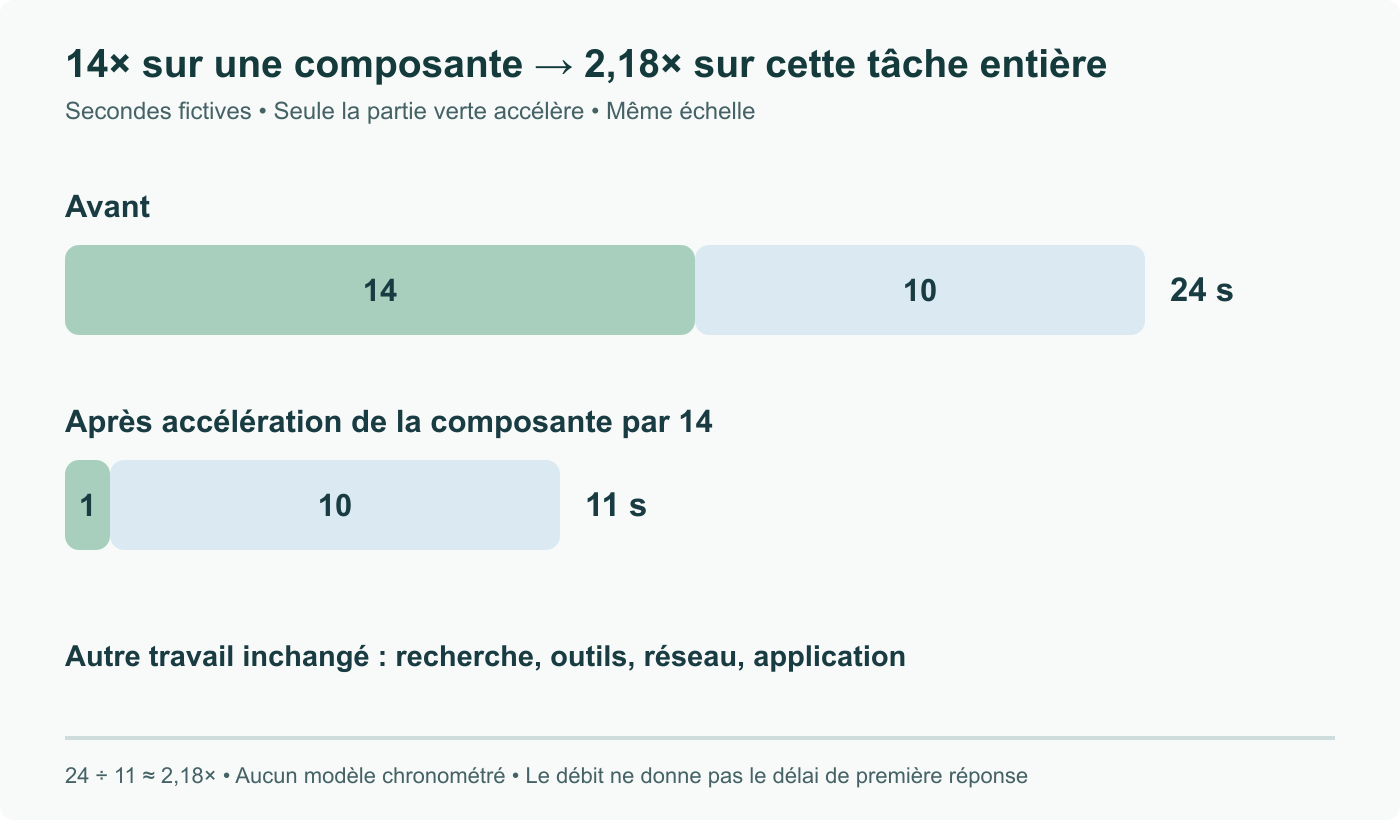
Notre workflow fictif passe 14 secondes dans la composante accélérée et dix ailleurs : 24 secondes au total. Si cette composante devient quatorze fois plus rapide, elle prend une seconde ; l’ensemble dure 11 secondes, soit environ 2,18× plus vite.
La couverture reprend ces hypothèses explicites, pas des mesures de Sol. Même une composante instantanée laisserait dix secondes ailleurs, limitant cet exemple à 2,4× globalement. Le débit de sortie ne garantit donc pas seul une réponse vocale en quelques centaines de millisecondes.
Mesurez séparément première sortie, génération, durée des outils et achèvement complet. Pour une séquence d’appels, relevez dépendances et nouvelles tentatives plutôt que de multiplier un débit impressionnant à toute l’application. Gardez les mêmes exigences de qualité : une réponse fausse rapide n’est pas une tâche métier accomplie. Avant de dépendre de l’avant-première, vérifiez chemin de requête pris en charge, conditions d’accès et solution de repli effectivement disponibles pour votre compte.
Revue du 8 septembre : sources primaires relues, données et statut actualisés, affirmations excessives retirées ; exemple explicatif original.