L’annonce ROCm 10 du 27 août réunit une nouvelle base de publication et les outils ROCm.AI. La CLI et AMD Skills sont en préversion. Un même numéro de version ne garantit pas une maturité ou une couverture matérielle identique pour chaque composant.
Lire le statut de chaque composant
La présentation de la version désigne TheRock comme base de construction et annonce une cadence d’environ six semaines. Elle qualifie la CLI de préversion technique et prévoit la consolidation des dépôts pour de futures versions. La présentation d’AMD Skills donne également au catalogue un statut de préversion.
Pour l’adoption, vérifiez le composant, le GPU et le système visés. Une version commune du SDK ne démontre pas que toutes les bibliothèques, tous les frameworks et tous les outils d’optimisation couvrent chaque famille matérielle annoncée.
Ce qu’Hyperloom cherche à optimiser
La documentation Hyperloom décrit une boucle de profilage de l’inférence, recherche des limites, modification du code hôte ou GPU et validation. Elle produit notamment des changements de code et un rapport. Son périmètre Linux ne doit pas être étendu implicitement à toutes les plateformes ROCm.
Trouver un noyau GPU plus rapide constitue un résultat intermédiaire utile. Le gain applicatif dépend de sa part dans la durée initiale et du respect de la précision attendue après modification.
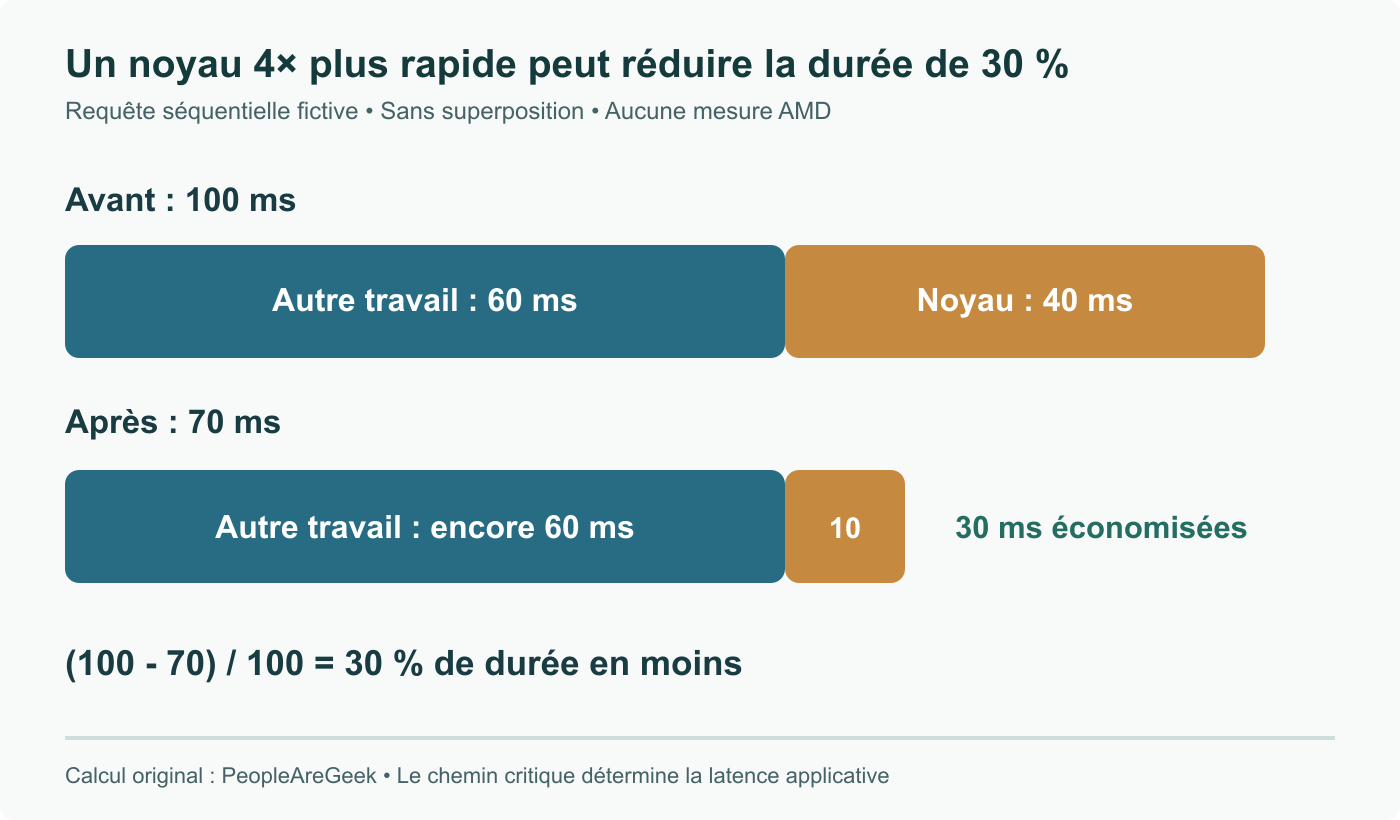
Un noyau quatre fois plus rapide peut économiser 30 %
Prenons une requête séquentielle fictive de 100 ms : 60 ms hors du noyau GPU ciblé et 40 ms dans celui-ci. Si ce noyau devient quatre fois plus rapide, sa contribution descend à 10 ms. La requête dure alors 70 ms, pas 25 ms.
La réduction de durée est de 30 %. En supposant en plus une seule requête à la fois, sans autre facteur limitant, le débit augmenterait d’un facteur 100/70, soit environ 1,43. Ces nombres forment un exemple pédagogique original, pas un benchmark AMD.
Exécution parallèle, transferts superposés et traitement par lots demandent un modèle plus détaillé. Additionner les durées des noyaux peut compter deux fois du travail simultané. Regardez la chronologie complète pour identifier le chemin qui détermine réellement la fin de la requête.
Garder une trace utile d’une optimisation
Conservez code initial, dimensions d’entrée, précision, versions logicielles et configuration matérielle. Fixez les tolérances de résultat avant de rechercher une implémentation plus rapide. Comparez ensuite plusieurs mesures complètes dans les mêmes conditions de préchauffage et de concurrence.
Notez les candidats rejetés autant que celui retenu : produire plus vite des valeurs fausses n’est pas une optimisation. Testez aussi des dimensions différentes du cas utilisé pendant le réglage si l’application doit les accepter.
ROCm.AI peut aider à organiser ce travail. L’annonce de version ne fournit à elle seule ni la preuve de compatibilité de votre machine ni le gain de votre modèle.
Sources revérifiées le 8 septembre ; statut, limites et explications corrigés, illustration remplacée.