Accepter un script batch ne suffit pas à établir sa compatibilité. Il faut vérifier que ressources, dépendances et comptabilité conservent le même sens.
Ce qu’AMD a publié
La présentation Spur du 22 juillet décrit un ordonnanceur Rust avec commandes Slurm, placement GPU sensible à la topologie, gestion CDI et réplication Raft. Le dépôt Apache-2.0 est accessible. AMD précise que la parité Slurm étendue reste en développement : cela ne valide pas tous les scripts ou plugins existants.
La documentation de déploiement sépare contrôleurs et agents de calcul, recommande trois ou cinq contrôleurs pour la haute disponibilité et renvoie la production vers son outillage Ansible. Une démonstration sur un nœud ne teste pas cette architecture.
Quatre GPU ne décrivent pas tout le placement
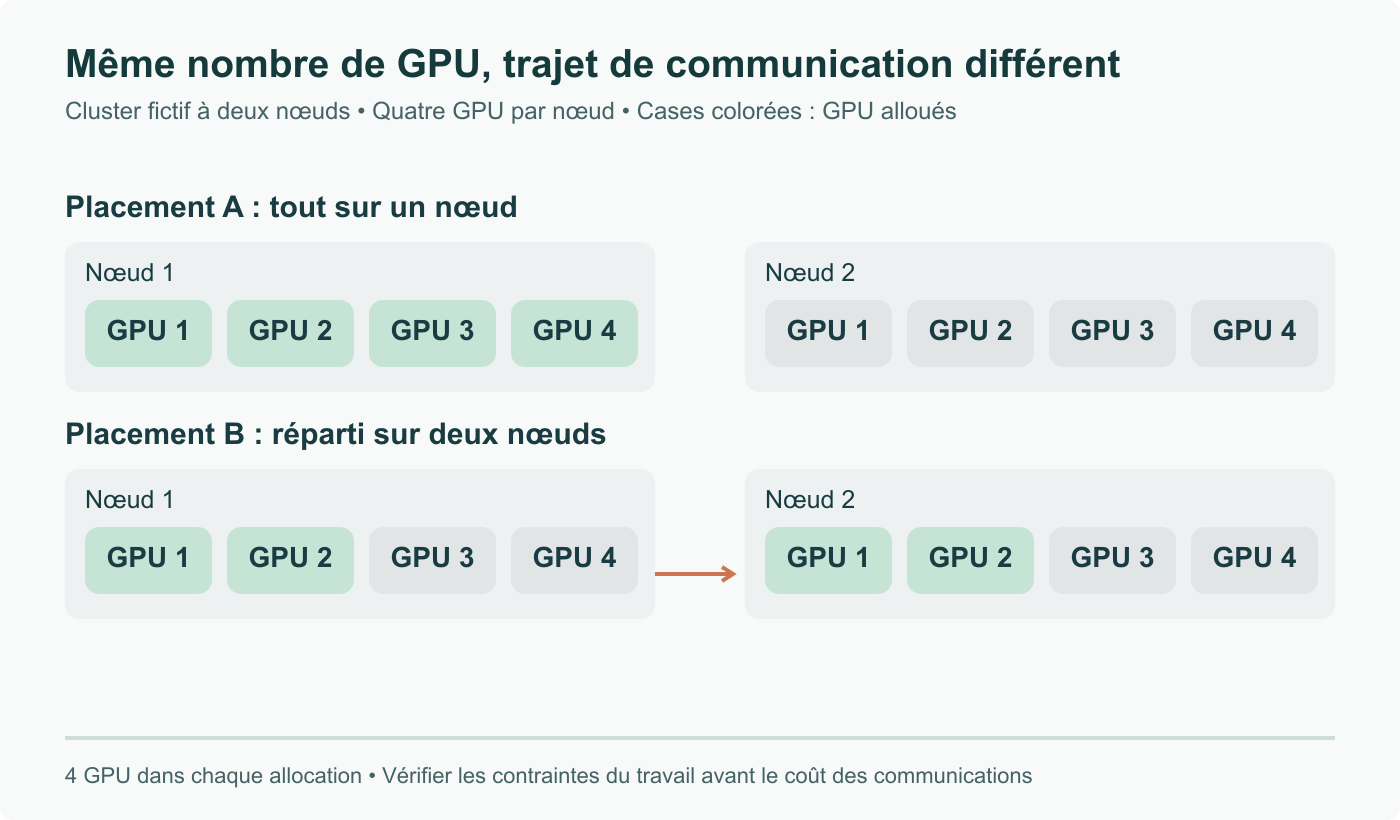
Notre schéma utilise un cluster fictif de deux nœuds ayant quatre GPU chacun. Un travail peut recevoir quatre GPU sur un nœud, ou deux sur chaque nœud. Le total reste quatre ; les communications empruntent des liens différents.
L’acceptabilité dépend du programme. Un travail limité à un seul nœud ne peut pas remplacer librement ce placement par une allocation répartie. Un programme distribué peut accepter les deux, avec des coûts de communication différents. L’exemple ne mesure ni Spur ni un interconnect particulier.
Pour l’évaluation, relever nombre de nœuds demandé, type d’accélérateur, tâches par nœud, identifiants GPU visibles et hôtes réellement attribués. Vérifier ensuite le nombre de processus lancés. Une ligne « running » dans la file ne répond pas à ces questions.
Compatibilité et reprise après panne
Un petit corpus représentatif peut comprendre un tableau de tâches avec un élément en échec, une dépendance qui doit rester bloquée, une annulation et un travail distribué. Comparer codes de sortie, libération des dépendances, restitution des ressources et écritures comptables avec l’ordonnanceur actuel. C’est une méthode d’évaluation proposée, pas un essai réalisé par PeopleAreGeek.
L’état du planificateur répliqué par Raft ne signifie pas que tous les services fonctionnent sans base : AMD attribue un rôle PostgreSQL séparé à Spur-Cloud. Perdre un contrôleur et perdre leur majorité sont deux scénarios différents. Mesurer reprise des soumissions et sort des travaux en cours ; un délai de bascule annoncé ne remplace pas les mesures de votre installation.
Revue du 8 septembre : compatibilité Slurm précisée, état du planificateur distingué de la comptabilité et exemple de placement ajouté sans mesure inventée.