Davantage de commentaires automatiques ne signifie pas forcément une meilleure revue. L’annonce CodeRabbit permet de distinguer activité et défauts réellement détectés.
Le financement et les fonctions annoncées
Dans son annonce d’août, CodeRabbit déclare 143 millions de dollars levés pour une valorisation de 1,5 milliard, avec Atomico et Smash Capital. Triage doit orienter les changements, Change Stack expliquer leurs relations et Security examiner le code déjà livré. Ce sont les descriptions de l’éditeur, pas une validation indépendante des performances.
Ces fonctions dépassent le commentaire de pull request. Prioriser consiste à choisir où porter l’attention ; expliquer, à relier les modifications ; examiner après fusion, à rechercher un problème atteignable dans le logiciel. Un nombre de revues ne répond pas aux trois questions.
Vingt alertes, deux limites différentes
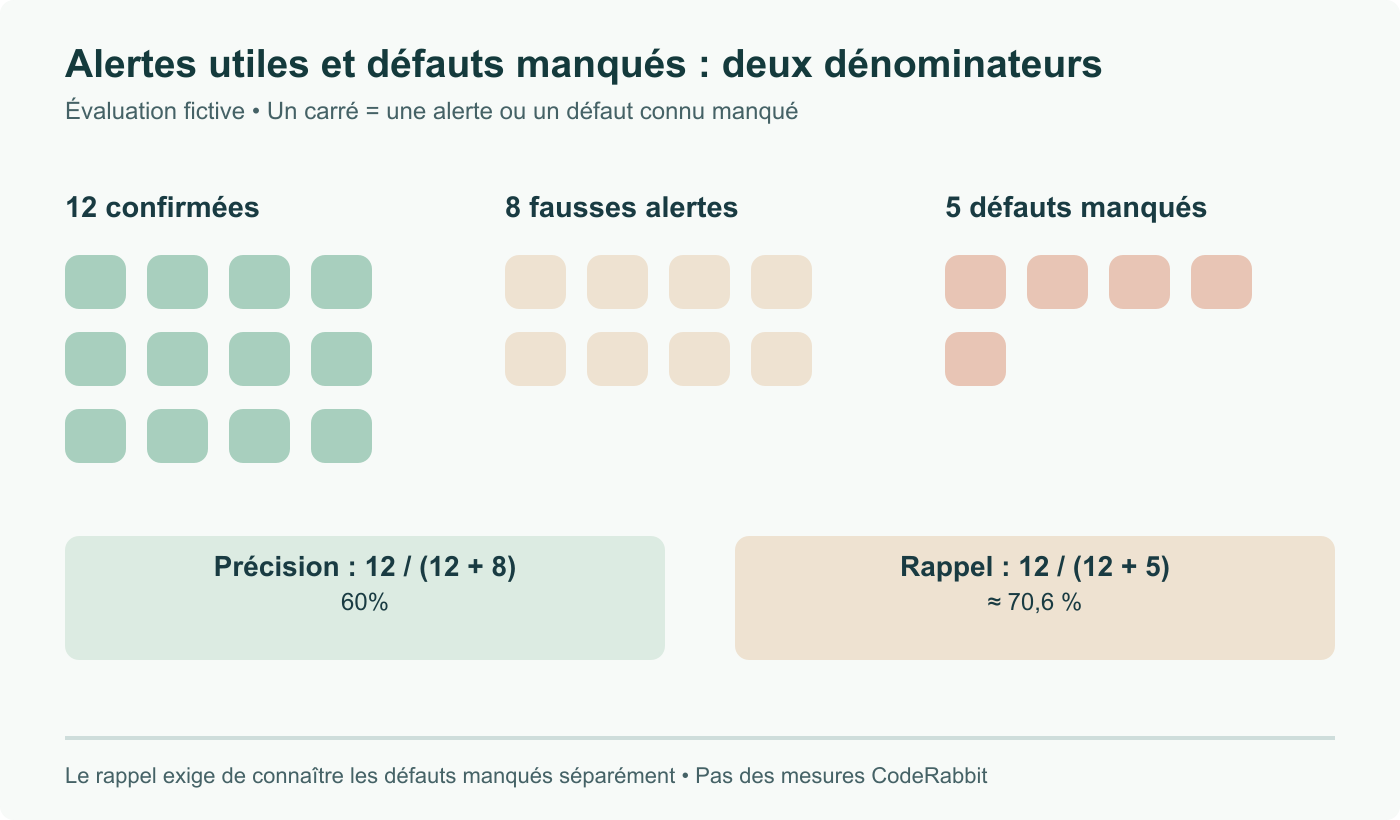
Notre évaluation fictive produit 20 alertes. L’examen manuel confirme 12 défauts et rejette huit alertes. La précision vaut 12 ÷ 20 = 60 % : la part des signalements utiles dans cet exemple.
Supposons qu’un jeu de tests vérifié séparément contienne cinq défauts supplémentaires que l’outil a manqués. Il a alors trouvé 12 défauts sur 17 connus, soit un rappel d’environ 70,6 %. Ce dénominateur exige de connaître les problèmes manqués ; la liste d’alertes de l’outil ne suffit pas.
La couverture sépare ces trois groupes. Aucun pourcentage ne mesure CodeRabbit. Ils montrent pourquoi moins commenter peut améliorer une revue, et pourquoi beaucoup commenter n’empêche pas de manquer une panne grave.
Évaluer la décision à prendre
Préparez des changements représentatifs avec défauts connus et des modifications saines qui doivent passer. Classez les résultats par conséquence : suggestion esthétique et contrôle d’autorisation oublié ne doivent pas se compenser dans une moyenne indistincte. Relevez la reproductibilité des preuves et le temps consacré à chaque alerte.
Pour le triage, examinez les contrats critiques touchés, même avec un petit diff. Pour la sécurité après fusion, vérifiez que le chemin signalé est atteignable dans la configuration déployée. La décision de livraison doit rester liée aux preuves et à un responsable. Le financement peut soutenir le produit ; il ne fournit pas ces résultats d’évaluation.
Revue du 8 septembre : sources primaires vérifiées, statut et limites précisés, explication originale et couverture utile.