Konstantin Ryabitsev, administrateur de kernel.org, estime qu’environ 2 % seulement des requêtes de git.kernel.org sont légitimes. La nuance compte : c’est une estimation d’exploitation explicitement incertaine, pas un recensement audité des visiteurs humains.
Garder trois dénominateurs distincts
Dans Creepy crawlies, Ryabitsev décrit environ six millions de requêtes quotidiennes, dont près de 66 % rejetées au défi et 33 % admises. Il indique qu’il est difficile de séparer sûrement robots et humains. Réussir le défi ne prouve pas qu’une personne navigue. Les pourcentages arrondis ne doivent pas devenir artificiellement un décompte exact à 100 %.
Son estimation de 2 % concerne les requêtes jugées légitimes, pas les comptes, personnes uniques ou l’ensemble des services kernel.org. Notre ancien titre effaçait ces distinctions.
Convertir correctement la capacité
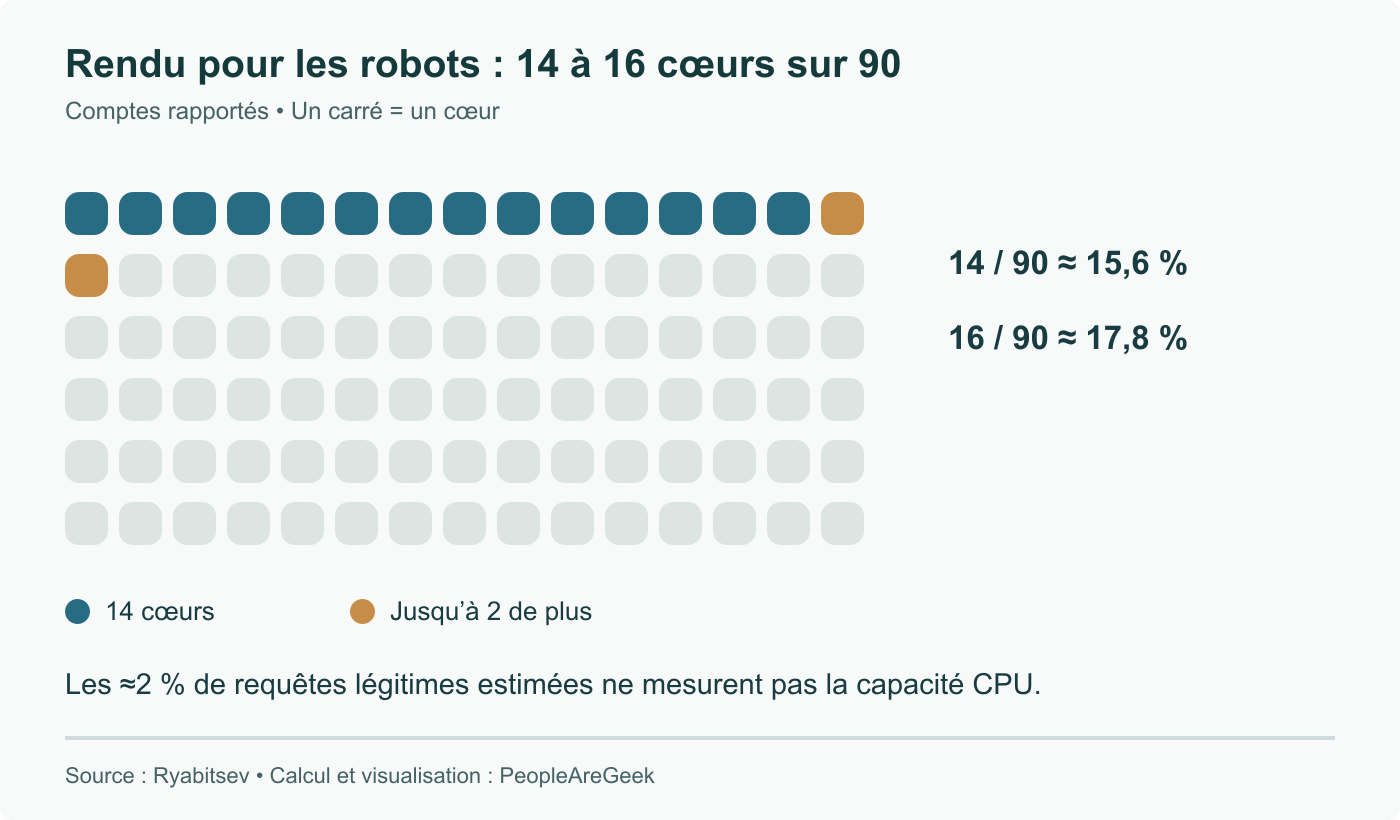
Le billet indique 14 à 16 cœurs occupés à générer des pages de commits pour les robots, sur 90 cœurs répartis entre cinq nœuds, et parle d’environ 20 % avec des pointes. Le calcul direct donne 14 / 90 = 15,6 % et 16 / 90 = 17,8 %. Le graphique montre cet intervalle et son dénominateur. Il ne transforme pas une approximation de l’auteur en mesure indépendante précise.
Proportion de requêtes et coût de traitement ne coïncident pas forcément. Une petite réponse en cache et une page de commit coûteuse comptent chacune pour une requête, avec des besoins CPU différents. Une requête bloquée peut consommer des ressources en périphérie sans atteindre le serveur d’origine.
Diagnostiquer son service par chemin
Pour un audit local utile, regroupez requêtes par endpoint, taille de réponse, latence et résultat du cache. Cherchez concentrations sur les URL coûteuses et rafales simultanées, pas seulement un user-agent suspect. Comparez le CPU d’origine sur les mêmes intervalles. Beaucoup de requêtes peu coûteuses ne forment pas le même incident que quelques traitements lourds.
Ne traitez pas la réussite d’un défi comme un signal d’identité humaine. Inversement, une adresse inconnue ou un client automatisé peut être légitime. Évaluez l’effet opérationnel du contrôle : moins de travail à l’origine, accès acceptable pour les utilisateurs visés et chemin documenté pour les consommateurs automatisés légitimes.
Éviter de reconstruire sans cesse la même vue Git
Ryabitsev distingue aussi le trafic robot de CI mal conçues effectuant des clones superficiels simultanés. Le projet grokmirror fournit des outils de miroir de dépôts. Un miroir local entretenu peut réduire les récupérations distantes répétées, mais demande gestion des mises à jour, stockage et vérification d’intégrité.
Avant de changer une pipeline, mesurez ses clones et testez le miroir sur un job jetable. Vérifiez la présence du commit demandé et construisez depuis cette révision exacte. Remplacer une récupération coûteuse par une copie périmée non vérifiée ne résout pas le besoin.
Sources
Incertitude de l’estimation de trafic rétablie ; défis, proportions de requêtes et capacité CPU distingués, avec calcul corrigé de 14 à 16 cœurs sur 90.