Automatiser les expériences permet de tenter davantage d’idées. Cela renforce aussi le besoin de séparer sélection d’un candidat et évaluation indépendante.
Les changements d’organisation sont documentés
Discovery Loop nomme Jeff Dean, Sanjay Ghemawat, Quoc Le et Oriol Vinyals comme fondateurs. L’entreprise veut automatiser les boucles expérimentales, d’abord en machine learning, puis les appliquer à sa propre infrastructure. Ce sont des objectifs, pas la preuve publiée qu’un système autonome les ait déjà atteints.
Le message Google du 5 août confirme investissement et partenariat Cloud. Demis Hassabis devient président de DeepMind et scientifique en chef d’Alphabet ; Koray Kavukcuoglu prend le rôle de SVP pilotant les opérations DeepMind. Aucune promesse de nouveau cycle d’API Gemini ou de calendrier de retrait plus fiable n’en découle.
Garder l’évaluation hors de la boucle de recherche
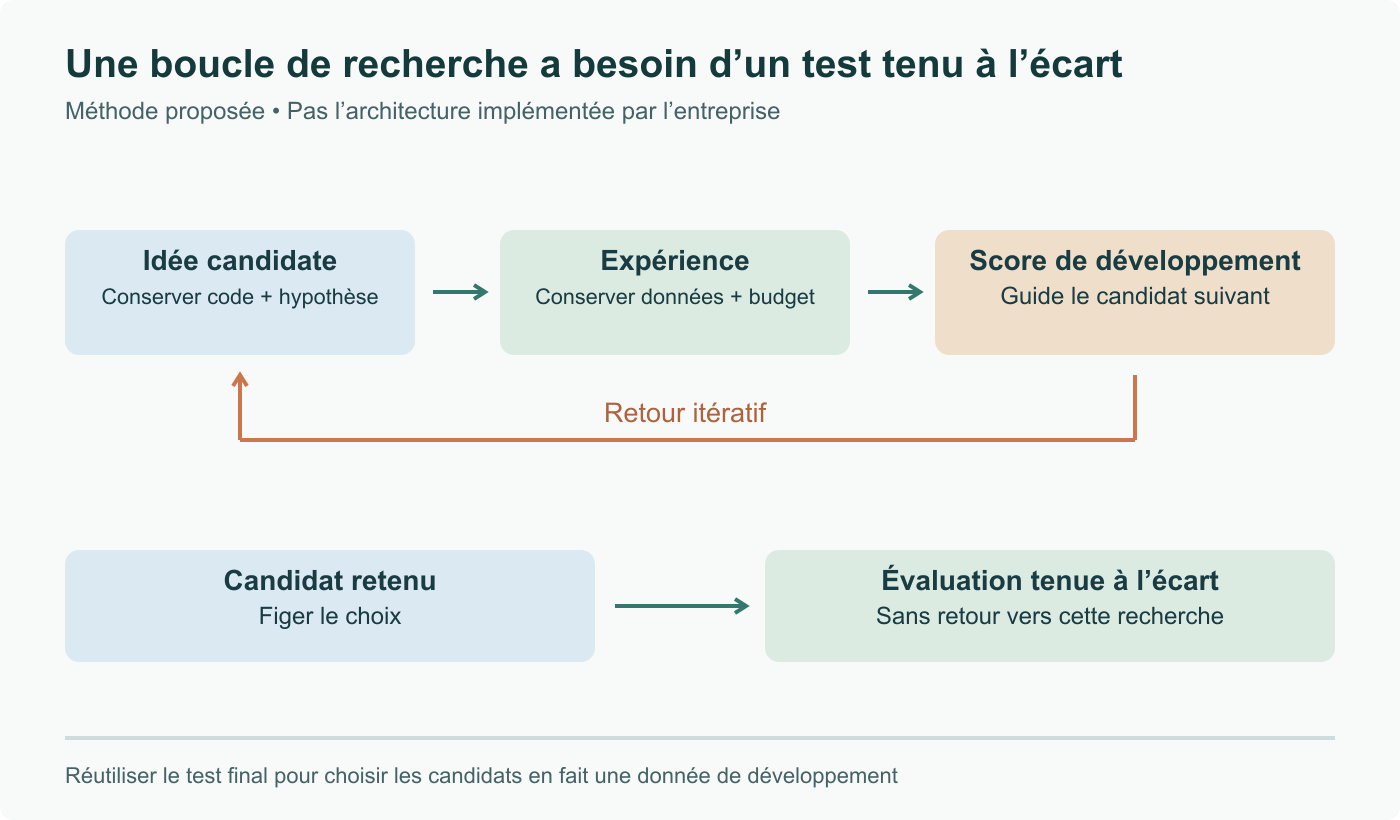
Notre schéma conceptuel part d’une idée candidate, lance une expérience, mesure le résultat sur un jeu de développement et utilise ce retour pour choisir l’idée suivante. Cette boucle peut se répéter. Une évaluation séparée, sur un jeu tenu à l’écart, reste réservée au résultat sélectionné.
Si le test prétendument indépendant guide régulièrement les décisions suivantes, il devient un élément de la recherche. Son score seul ne démontre plus les performances sur des données jamais utilisées. C’est une limite méthodologique, pas une description de l’implémentation actuelle de Discovery Loop.
Un système automatisé devrait conserver définition du candidat, révision du code, séparation des données, graine aléatoire et budget de chaque essai. Les essais infructueux comptent aussi : publier seulement le meilleur cache le nombre d’occasions de trouver un résultat favorable.
Ce qu’un premier résultat utile montrerait
Pour une amélioration fictive d’entraînement, comparer à la même référence sous un budget de calcul explicite. Donner variabilité des répétitions, contrôles de contamination et coût de toute la recherche, plutôt que du seul entraînement gagnant. Un modèle final moins cher peut avoir nécessité une recherche coûteuse ; les deux coûts répondent à des questions différentes.
Le parcours des fondateurs motive l’intérêt, sans remplacer ces éléments. La forme de société d’intérêt public ne garantit pas non plus une licence ouverte des futurs codes, données ou modèles. La preuve à suivre sera un résultat accompagné d’une méthode reproductible et d’affirmations délimitées, plutôt qu’une promesse déduite sur sa manière de publier.
Revue du 8 septembre : fondateurs et rôles vérifiés auprès des entreprises ; spéculations boursières et API retirées, limite d’évaluation de recherche ajoutée.