IBM a publié Granite 4.2 le 25 août en tailles 3B, 8B et 30B sous Apache 2.0. Toutes proposent réflexion configurable et appels d’outils. Le plus petit modèle ne suit pas toutes les étapes d’apprentissage par renforcement des deux autres.
La taille change aussi le parcours d’entraînement
Le compte rendu technique d’IBM réserve le bloc de renforcement agentique aux tailles 8B et 30B. Les appels d’outils du 3B ne prouvent donc ni un entraînement agentique identique ni une performance équivalente.
La fiche du modèle 3B décrit les modes avec réflexion, sans réflexion et à faible effort. Elle distingue contexte natif de 128K et extension à 512K. La limite réellement servie dépend encore de la configuration et de la mémoire disponible.
La taille des poids n’est pas tout le besoin mémoire
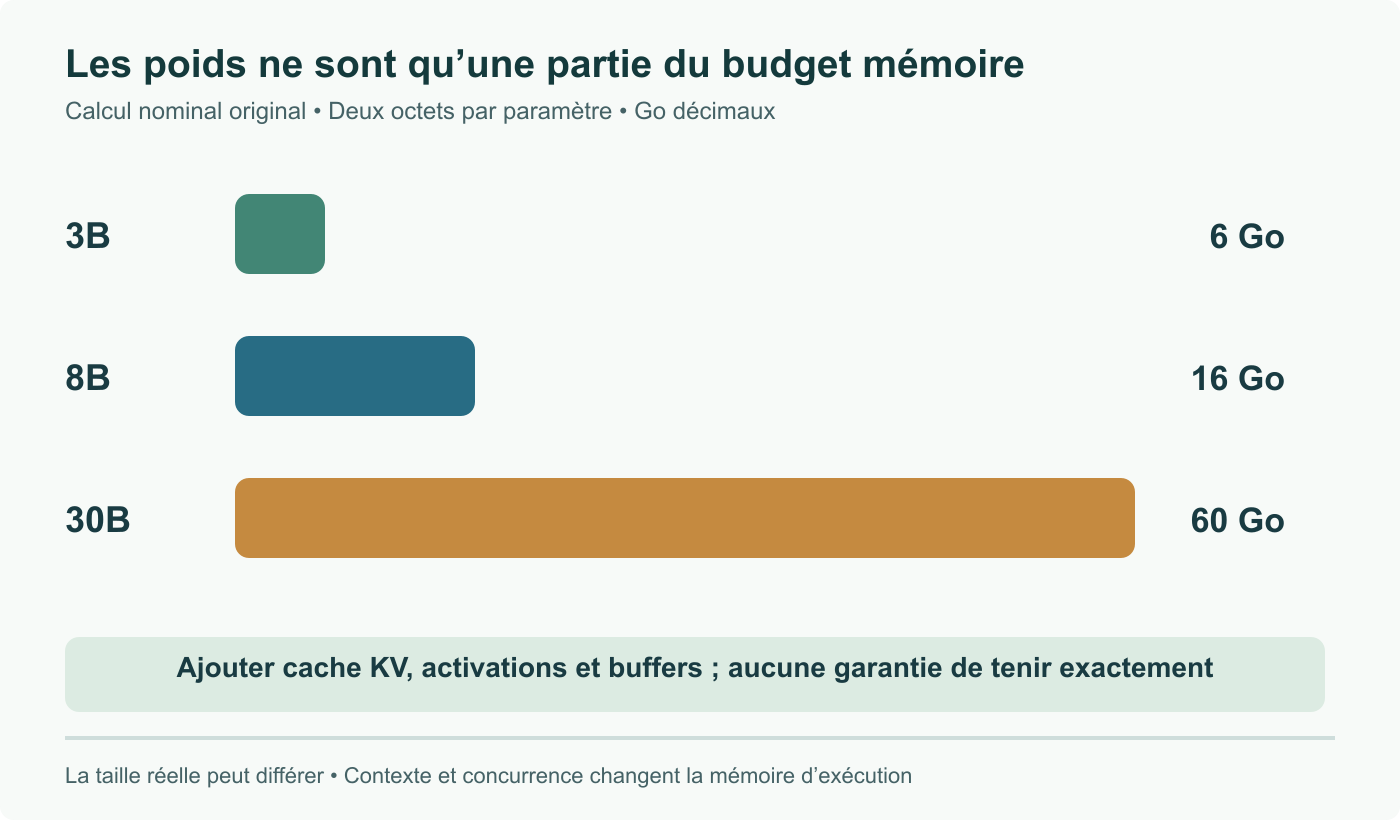
Une estimation minimale originale part du nombre nominal de paramètres. À deux octets par paramètre, trois milliards demandent environ 6 Go décimaux pour les poids seuls ; huit milliards environ 16 Go, et trente milliards environ 60 Go. Taille réelle du checkpoint et détails d’implémentation peuvent différer.
Ces valeurs excluent cache KV, activations temporaires, buffers et autres allocations. Elles ne promettent pas le fonctionnement sur une carte disposant d’exactement cette capacité. La quantification change le calcul et apporte ses propres détails de représentation.
Si une installation fictive utilise déjà 6 Go de poids, ajouter un budget de cache de 2 Go demande au moins 8 Go avant les allocations restantes. Allonger le contexte ou multiplier les requêtes simultanées peut augmenter le cache sans changer le fichier du modèle.
Comparer les résultats plutôt que la longueur de réflexion
Une évaluation pratique utilise des tâches fixes dont les réponses sont vérifiables. Exécutez chaque mode avec les mêmes formats de prompt, budget de sortie et paramètres de service. Comptez les résultats finaux corrects et mesurez le délai jusqu’à la réponse finale.
Pour une tâche avec outil, vérifiez aussi nom, arguments et autorisation de l’opération. Un appel syntaxiquement valide ne prouve pas la pertinence de l’action. Une longue trace de réflexion ne remplace aucun de ces contrôles.
PeopleAreGeek n’a pas testé ces checkpoints. La version fournit plusieurs tailles et réglages à évaluer ; le choix doit suivre le budget applicatif et la réussite mesurée, pas l’hypothèse que réfléchir plus longtemps améliore toujours la réponse.
Revue du 8 septembre : sources primaires, portée des annonces et exemples vérifiés ; illustration remplacée.