La première branche publique de Multikernel, v7.0-mk2, exécute plusieurs noyaux sur des ressources physiques attribuées. Cette approche expérimentale vise les charges divisibles, avec un fonctionnement différent d’une machine virtuelle ou d’un conteneur.
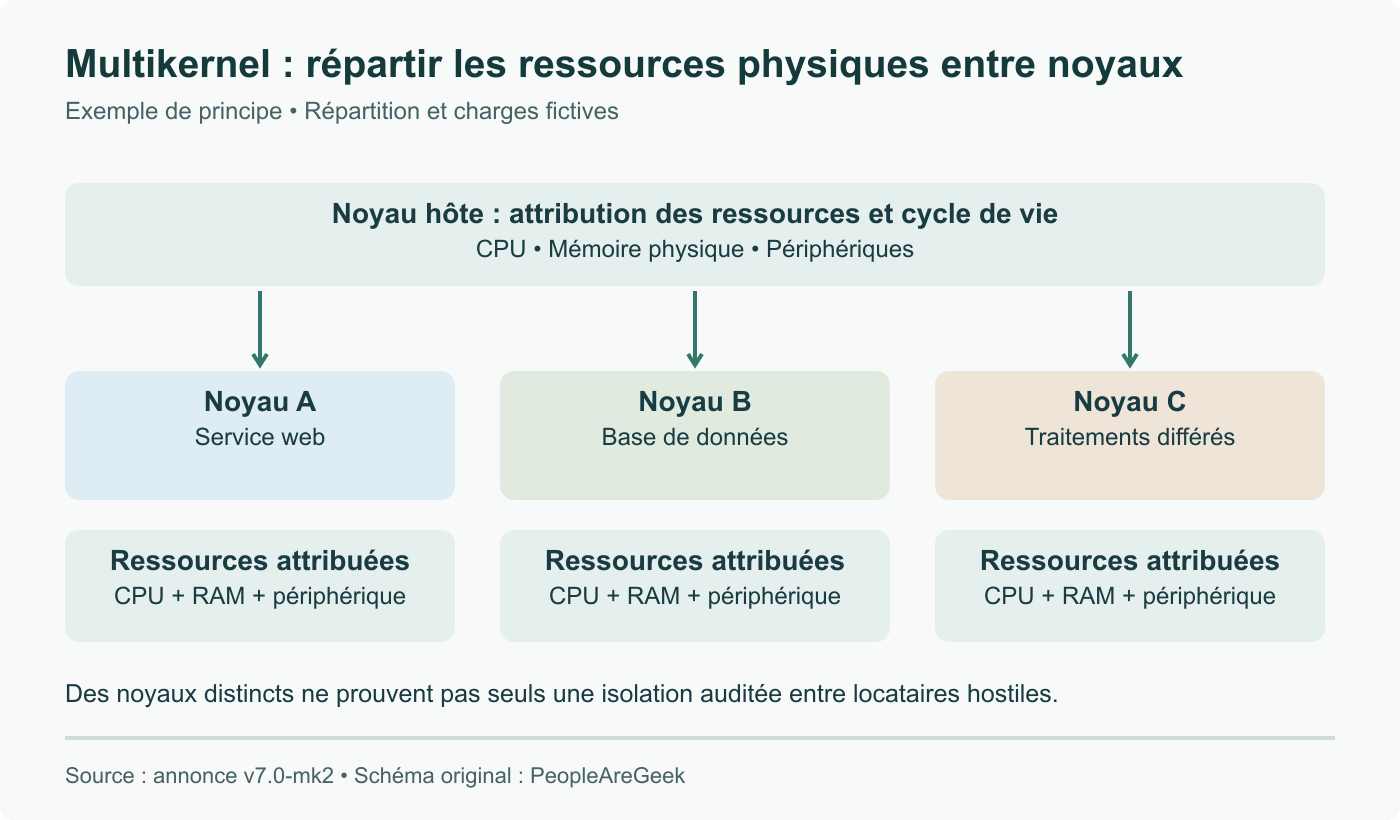
Des ressources dédiées à chaque noyau
L’annonce du 25 août de Cong Wang décrit un hôte attribuant CPU, mémoire et périphériques PCI, puis démarrant des noyaux supplémentaires via un chemin kexec_file_load() étendu. Cette version prend en charge x86_64 et repose sur Linux 7.0 ; c’est une branche distincte, pas l’annonce d’une intégration de l’ensemble dans Linux amont.
Le guide du projet présente les composants associés : noyau modifié, gestionnaire Kerf et Lazy CMA pour les pools mémoire. DAXFS s’ajoute pour le parcours documenté utilisant une image Docker ou un répertoire partagé. L’image Docker fournit ici un système de fichiers ; cela ne transforme pas l’instance en conteneur classique partageant un noyau.
Ce que les durées publiées permettent de conclure
L’auteur rapporte un essai lmbench sur un serveur à deux Xeon Gold 5418Y, SMT désactivé. Une instance de deux cœurs et 1 Go est comparée à une VM KVM de deux vCPU épinglés et 1 Go. La commutation entre deux processus prend 1,37 microseconde contre 3,42, soit un rapport proche de 2,50. Il s’agit des mesures du projet, pas de nos essais ni d’une promesse d’applications 2,5 fois plus rapides.
Prenons un calcul volontairement simplifié : si ces commutations représentent 10 % du temps total d’un programme, accélérer seulement cette part par 2,5 donne une durée de 0,90 + 0,10 / 2,5 = 0,94, soit une vitesse globale d’environ 1,06 fois l’originale. L’exemple suppose tout le reste constant et ne décrit aucune charge réellement mesurée. Il montre pourquoi un ratio de microbenchmark ne s’applique pas à tout un service.
Vérifier la divisibilité avant les performances
Déterminez quels processus peuvent vivre indépendamment. Si une application exige un espace d’adressage partagé entre tous ses threads, dessiner deux noyaux ne divise pas gratuitement cette mémoire. Si la séparation introduit un échange réseau, mesurez communication et sérialisation en plus de la contention éventuellement évitée.
Des noyaux distincts ne prouvent pas non plus une frontière de sécurité auditée face à des locataires hostiles. Attribution matérielle, DMA, mémoire partagée, firmware et contrôle par l’hôte restent à examiner dans l’implémentation et le déploiement retenus. Les essais de résistance aux plantages rapportés par le projet ne tranchent pas tous les scénarios d’exploitation.
Évaluez cette branche sur du matériel de laboratoire dédié. Relevez placement des ressources, topologie NUMA, mémoire, politique d’énergie, modules de sécurité et configuration KVM comparée. Testez restitution des ressources et récupération, autant que le débit stable. Nous n’avons ni installé ni benchmarké cette branche pour cet article.
Sources
Vérification de la première publication et du guide ; microbenchmarks de l’auteur distingués des performances applicatives, isolation nuancée et architectures non prises en charge exclues.