Nvidia a annoncé Groq 3 LPX en production le 24 août. Son chiffre phare atteint environ 3 400 tokens de sortie par seconde sur Gemma 4 31B avec un contexte de 100K. Il décrit une charge d’inférence précise, pas la durée de toute tâche de code.
Ce que l’annonce établit
Le communiqué Nvidia attribue ce résultat à Artificial Analysis. Il désigne Nebius comme premier adoptant et prévoit l’accès dans Token Factory. Groq décrit également ses projets d’adoption.
Production matérielle, adoption par un fournisseur et ouverture d’une API publique constituent des étapes distinctes. Vérifiez service réel, modèle disponible et limites avant de considérer ce débit comme accessible avec un compte API existant.
Suivre une étape complète de l’agent
Un agent peut traiter un prompt, générer un appel d’outil, attendre cet outil, puis traiter son résultat et générer une nouvelle réponse. Accélérer la génération raccourcit une partie de la boucle, sans accélérer automatiquement compilation, recherche distante ou base de données.
Un exemple original chiffre cette limite. Une étape séquentielle prend 2 secondes de génération et 3 secondes d’attente d’outil. Multiplier la vitesse de génération par quatre réduit cette partie à 0,5 seconde. L’étape complète passe de 5 à 3,5 secondes : 30 % de temps en moins, pas une vitesse globale multipliée par quatre.
Ce calcul fictif n’est pas un benchmark LPX. Une étape réelle peut ajouter file d’attente, traitement du prompt, délais réseau et appels supplémentaires. Des opérations simultanées demandent une chronologie plutôt qu’une simple somme.
Comparer au point de fonctionnement utile
Pour une application interactive, mesurez délai jusqu’à la première sortie utile, rythme de génération suivant et durée jusqu’au résultat final. Conservez longueurs d’entrée et de sortie, concurrence et réglages du modèle. Un prompt court ne se compare pas directement au cas annoncé avec 100K de contexte.
Gardez aussi le critère de réussite. Un correctif généré plus vite mais échouant aux tests n’achève pas la tâche de programmation. Le débit de tokens mesure l’infrastructure ; la réussite utile inclut justesse et reste du processus.
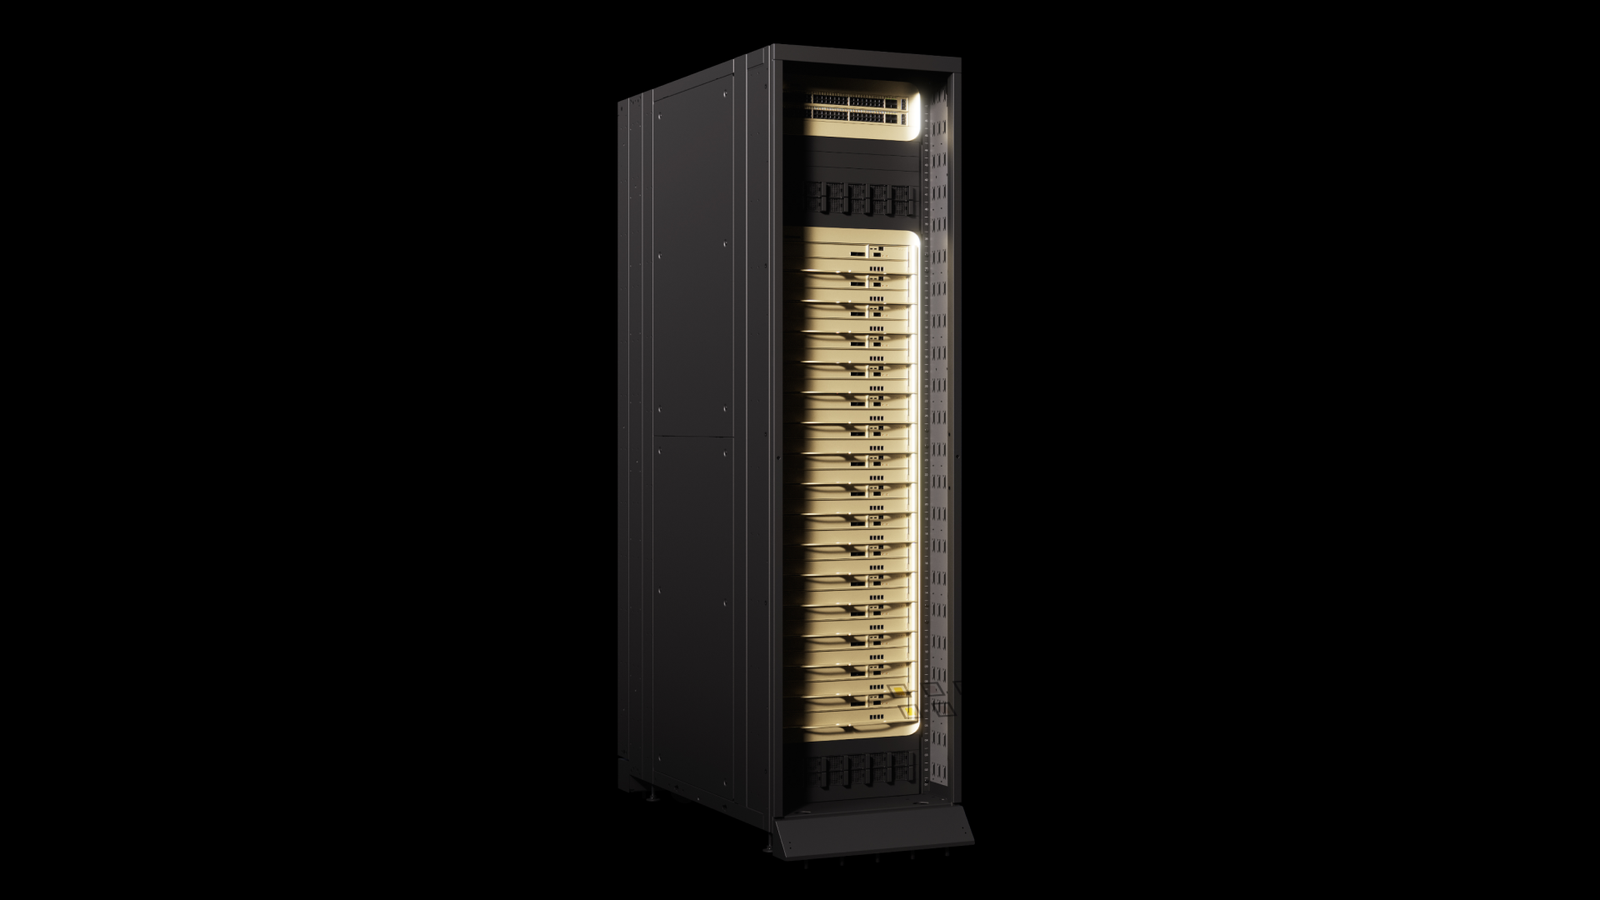
Le visuel officiel de la baie représente le produit présenté par Nvidia, pas une installation PeopleAreGeek. Nous n’avons exploité ni ce matériel ni le service annoncé. Le périmètre mesuré doit accompagner le chiffre pendant son arrivée chez les fournisseurs.
Revue du 8 septembre : sources primaires, portée des annonces et exemples vérifiés ; illustration remplacée.