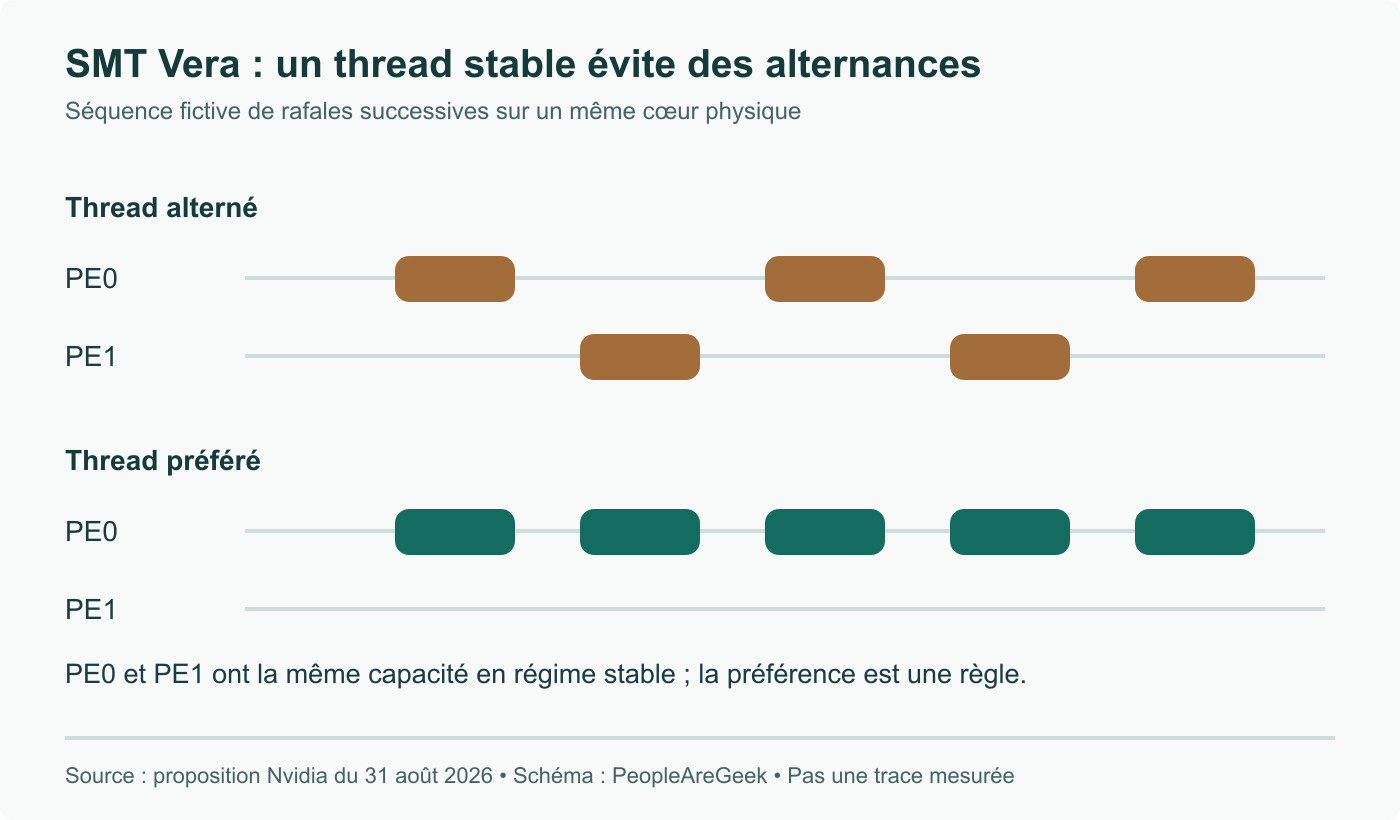
La proposition du 31 août de Nvidia privilégie PE0 lorsque les deux threads d’un cœur Olympus sont disponibles. C’est un choix de placement stable, pas l’affirmation que PE0 serait intrinsèquement plus rapide que PE1.
Le coût se situe dans la transition
La présentation des correctifs par Andrea Righi décrit deux éléments de traitement symétriques partageant un cœur. Le retour aux ressources complètes en mode monothread demande un délai après l’inactivité de l’autre thread. Alterner le thread actif peut donc coûter du temps même si le travail utile se chevauche très peu.
La proposition choisit d’abord un cœur inactif, puis son thread disponible préféré. Le comportement générique exige un domaine SMT SD_ASYM_PACKING fourni par l’architecture. Il ne s’active pas indistinctement sur toutes les machines SMT.
La frise représente des rafales successives : les maintenir sur PE0 laisse PE1 inactif. Elle ne trace pas des durées mesurées et ne recommande pas de fixer manuellement toutes les tâches sur PE0.
Lire le benchmark avec ses conditions
L’auteur rapporte environ 9,4 à 10,1 TFLOP/s sur un GEMM en simple précision, à 88 threads sur 88 cœurs physiques d’un nœud NUMA d’un système Vera à deux nœuds. À partir de ces arrondis, (10,1 / 9,4 - 1) × 100 donne environ 7,4 %.
Ce calcul provient de l’expérience Nvidia, pas d’un benchmark PeopleAreGeek ni d’un gain SMT universel. Il ne faut pas le combiner aux résultats d’anciens correctifs comme s’ils partageaient une même référence. La précédente version mêlait cette proposition aux travaux antérieurs de capacité asymétrique et à un chiffre proche de 2× ; ce récit a été remplacé.
Les conditions d’une comparaison indépendante
Conservez charge, nombre de threads, affinité, placement NUMA, options de compilation et noyau de référence identiques. Répétez les essais en gardant débit et dispersion. Une tâche occupant continuellement les deux threads ne correspond pas à des rafales monothread intermittentes.
En production, établissez d’abord si votre noyau et votre architecture activent cette politique. Une discussion sur la liste ne constitue pas une fonction livrée par la distribution. Fixer manuellement les processus d’un autre serveur à partir de cet article pourrait contrarier d’autres décisions de l’ordonnanceur.
La leçon générale est plus précise : deux processeurs logiques peuvent avoir la même capacité nominale tandis que leur activité précédente modifie les ressources immédiatement disponibles. Une moyenne d’utilisation peut masquer ces transitions.
Source
- Andrea Righi : threads SMT préférés sur Nvidia Olympus, 31 août 2026
- Schéma et calcul du pourcentage par PeopleAreGeek ; mesures de performance par l’auteur des correctifs.
Remplacement du récit confondu avec les travaux de mars par le mécanisme exact d’août ; distinction des PE symétriques et du benchmark fournisseur.