Les achats de Mac mini et Mac Studio attribués à OpenAI pour les agents posent une question d’architecture : la machine héberge-t-elle le bureau piloté, le modèle qui décide, ou les deux ? Cette distinction change le sens d’une comparaison matérielle.
Séparer l’achat rapporté de l’architecture supposée
L’article de Wccftech attribue l’information à The Information. Nous n’avons ni inventaire de déploiement ni comparaison contrôlée des coûts d’OpenAI. Cela ne justifie pas nos anciennes affirmations selon lesquelles les Macs coûteraient nécessairement moins cher que des serveurs GPU par environnement, ou que la mémoire unifiée expliquerait cet achat précis.
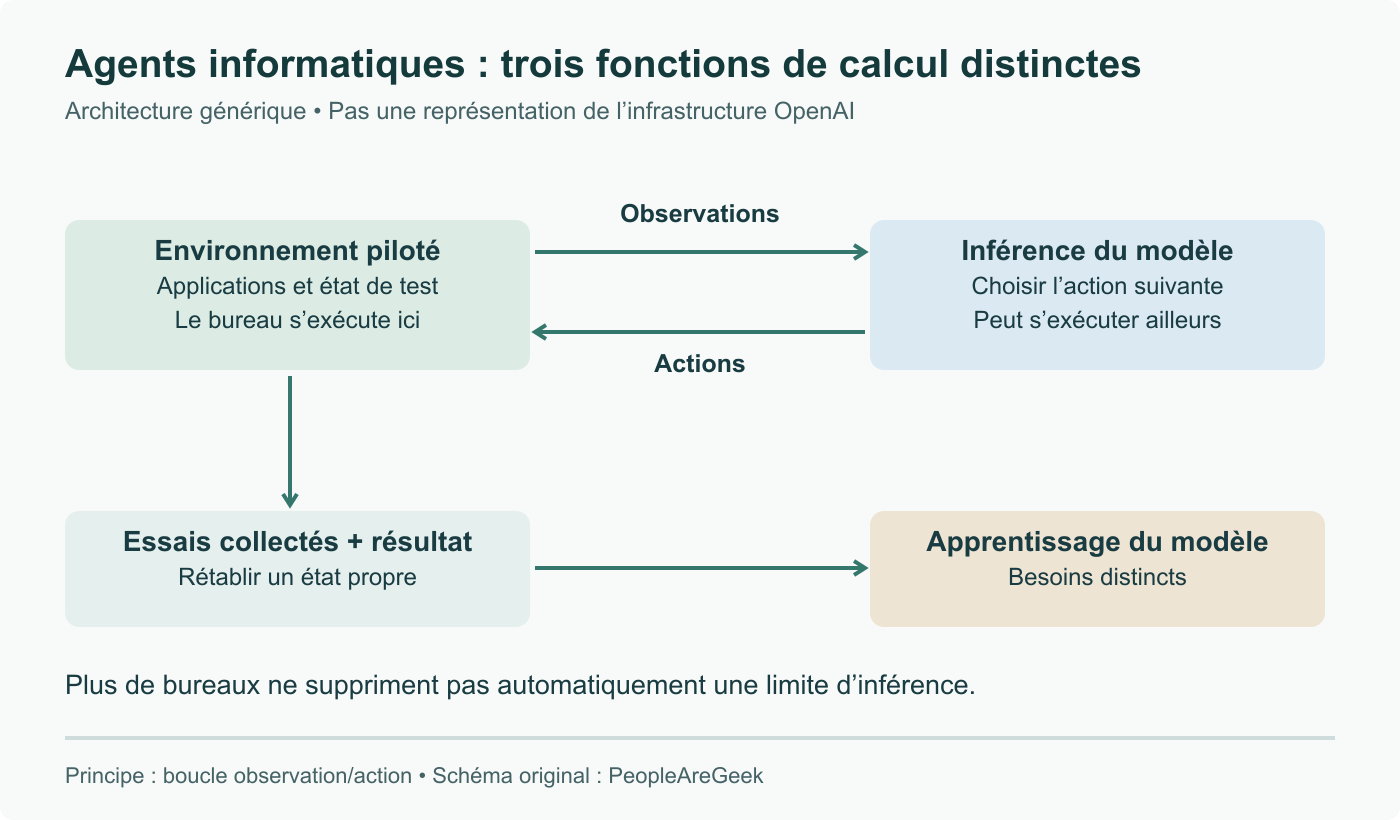
Le schéma présente une architecture générique, pas une vue interne de cette flotte. Il sépare trois fonctions : exécuter les applications dans un environnement, sélectionner les actions avec un modèle et mettre à jour le modèle pendant l’apprentissage. Elles peuvent utiliser des ressources différentes et ne pas résider sur le même ordinateur.
Un bureau n’héberge pas forcément l’apprentissage
La présentation de recherche Computer-Using Agent de janvier 2025 décrit une boucle de captures, décisions et actions à la souris ou au clavier. Une machine affichant une application peut fournir les observations et appliquer les actions tandis que l’inférence tourne ailleurs. Les interactions répétées peuvent produire des données d’apprentissage ; exécuter un bureau ne révèle pas où les gradients sont calculés.
Pour votre propre évaluation, mesurez séparément démarrage de l’application, capture de l’observation, réponse du modèle, exécution de l’action et remise à zéro. Si réinitialiser un compte de test prend plus de temps que l’inférence, un accélérateur plus rapide ne supprimera pas seul ce délai. Inversement, ajouter des bureaux ne désature pas un service de modèles.
Un calcul de capacité vérifiable
Supposons un essai de 90 secondes suivi de 30 secondes pour restaurer un état propre. Un environnement occupé en continu termine théoriquement 3 600 / 120 = 30 essais par heure. Vingt environnements donnent 600 essais par heure avant échecs, files d’attente et limites partagées. Ce sont des valeurs fictives illustrant le dimensionnement, pas des chiffres provenant des laboratoires.
Mesurez les essais réussis et valides autant que les essais lancés. Une réinitialisation qui laisse le document de la veille peut donner l’impression d’un succès pour la mauvaise raison. Rendez reproductibles état du compte, version de l’application et fichiers initiaux.
La location ne se libère pas forcément à la minute
AWS documente EC2 Mac sur des hôtes dédiés physiques, avec une instance Mac par hôte et une allocation minimale de 24 heures avant libération. Ce fonctionnement vérifié est distinct de toute information concernant un client particulier.
Comparez un devis locatif aux heures réellement utilisables dans cette période, en incluant préparation et réinitialisation. Pour l’achat, comptez maintenance, énergie, réseau et capacité inactive. Le nom d’une puce ne désigne pas à lui seul le gagnant. L’affirmation selon laquelle les commandes d’OpenAI auraient provoqué le calendrier de renouvellement d’Apple a été retirée : nous n’avons pas de preuve indépendante de ce lien causal.
Sources
- Article attribuant l’information sur les achats
- Recherche Computer-Using Agent d’OpenAI, janvier 2025
- Documentation AWS EC2 Mac
Achats rapportés maintenus avec attribution ; retrait des coûts supposés et des hypothèses de modèles locaux, distinction environnement/modèle et contraintes EC2 Mac expliquées.