Après une sortie à poids ouverts, la question utile est ce que l’on peut exécuter, avec quelle précision et quel contexte. Le seul nombre « 27B » ne donne pas la mémoire GPU nécessaire.
Ce qui est publié
La fiche officielle Qwen3.8-27B décrit des poids Apache 2.0, une architecture multimodale à attention hybride et un contexte natif de 262 144 tokens. Les poids permettent inspection et déploiement sous licence ; cela ne signifie pas que toutes les données et la procédure d’entraînement sont publiées.
Le raisonnement est activé par défaut. Le comportement dépend donc du modèle de conversation et des paramètres du moteur, pas seulement du nom des poids. Les scores de l’éditeur concernent son protocole annoncé ; ce ne sont ni nos mesures indépendantes, ni une prévision pour chaque projet logiciel.
Un calcul limité aux poids
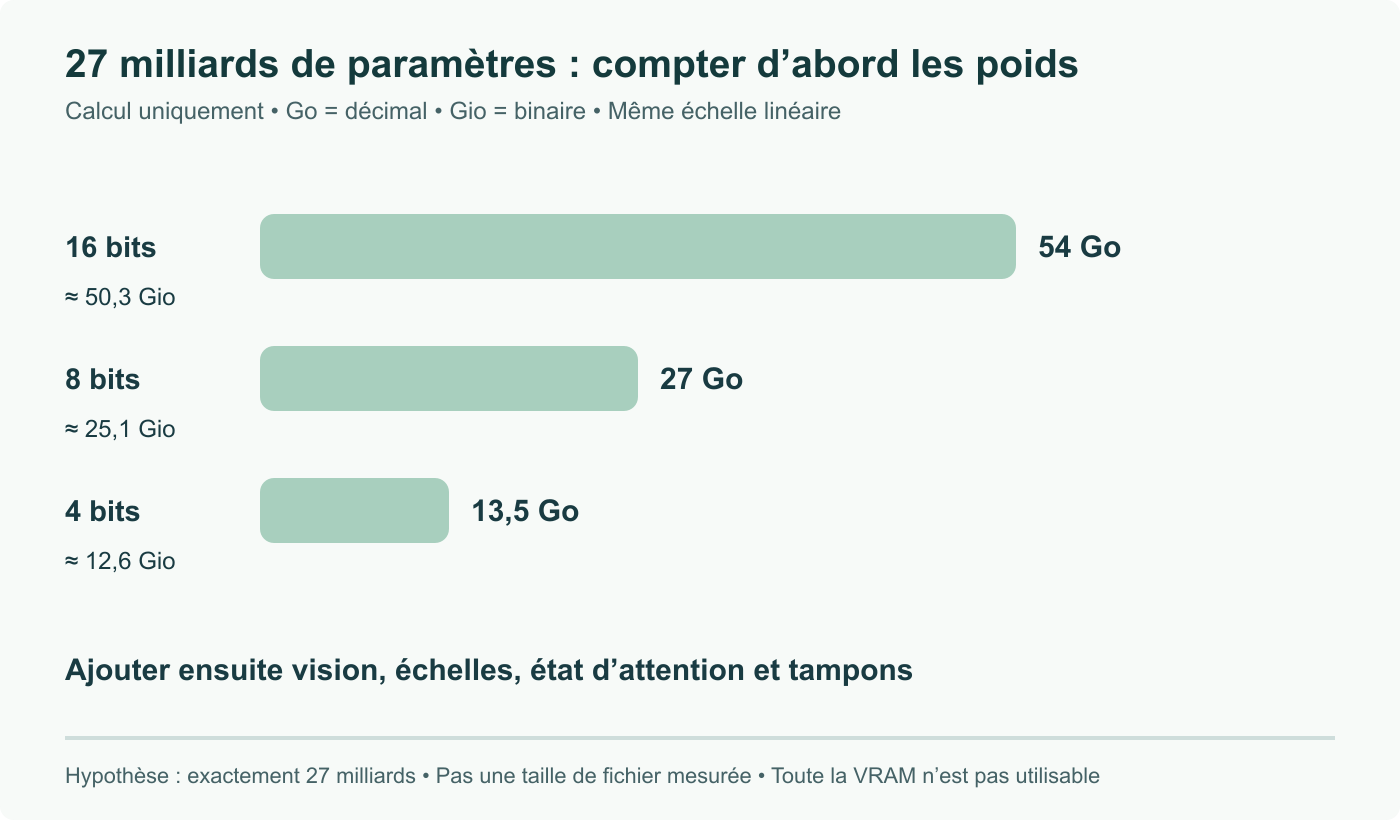
Pour un ensemble simplifié d’exactement 27 milliards de paramètres, multipliez leur nombre par les octets stockés par paramètre. En 16 bits : 54 Go, soit environ 50,3 Gio. En huit bits : 27 Go ou 25,1 Gio ; en quatre bits : 13,5 Go ou 12,6 Gio.
Ces valeurs illustrées sont des calculs. Elles excluent tenseurs supplémentaires, échelles de quantification, vision, activations, état de l’attention, tampons et allocations du moteur. Le Go emploie des puissances de 1 000 ; le Gio, de 1 024. Comparer directement « 13,5 Go » à la capacité annoncée d’une carte pour déclarer que le service tient oublie une grande partie du problème.
La recette du moteur précise les conditions
La recette vLLM décrit plusieurs configurations distinctes. L’exemple NVFP4 sur une RTX 5090 utilise un maximum de 32 768 tokens et l’exécution eager ; les exemples à deux cartes ont d’autres réglages. Ce sont les validations des auteurs de la recette, pas des mesures PeopleAreGeek. Une quantification tierce reste aussi un fichier différent du modèle FP8 officiel.
Pour un essai reproductible, notez révision des poids, origine de la quantification, version du moteur, mémoire utilisable, contexte maximal et nombre de séquences simultanées. Essayez une requête courte représentative, puis un document long et plusieurs requêtes concurrentes. Contrôlez justesse et durée des tâches terminées en plus du pic mémoire.
Un serveur qui démarre avec un petit prompt peut échouer sur un lot plus grand. À l’inverse, réduire le contexte maximal peut rendre une configuration utilisable sans changer le modèle. Explicitez ces compromis au lieu de promettre un fonctionnement local sur toute machine ou de transformer un classement de benchmark en conseil matériel.
Revue du 8 septembre : retour aux sources primaires, correction du périmètre et du statut des annonces, explication originale illustrée.