Wispr a annoncé sa série B de 280 millions de dollars le 17 août avec une préversion de Canto. Il faut distinguer les mots bien reconnus des dictées complètes qui ne demandent aucune retouche.
Ce qui était annoncé et ce qui était attendu
L’annonce officielle parle d’une préversion, pas d’une sortie sans restriction pour tous. Elle indique une valorisation de 2 milliards de dollars et un taux d’erreur de mots en conditions bruyantes passant de plus de 30 % à 5-10 %. Elle attend 30-35 % de dictées nécessitant une retouche en moins. Ce dernier chiffre concerne les dictées touchées, pas nécessairement le nombre d’opérations d’édition individuelles.
Ce sont les chiffres et attentes de Wispr. Ils ne déterminent pas le résultat avec votre microphone, accent, mélange de langues ou vocabulaire technique. Une amélioration annoncée du modèle ne constitue pas un test indépendant de toutes les plateformes Flow.
Un même total d’erreurs peut produire deux expériences
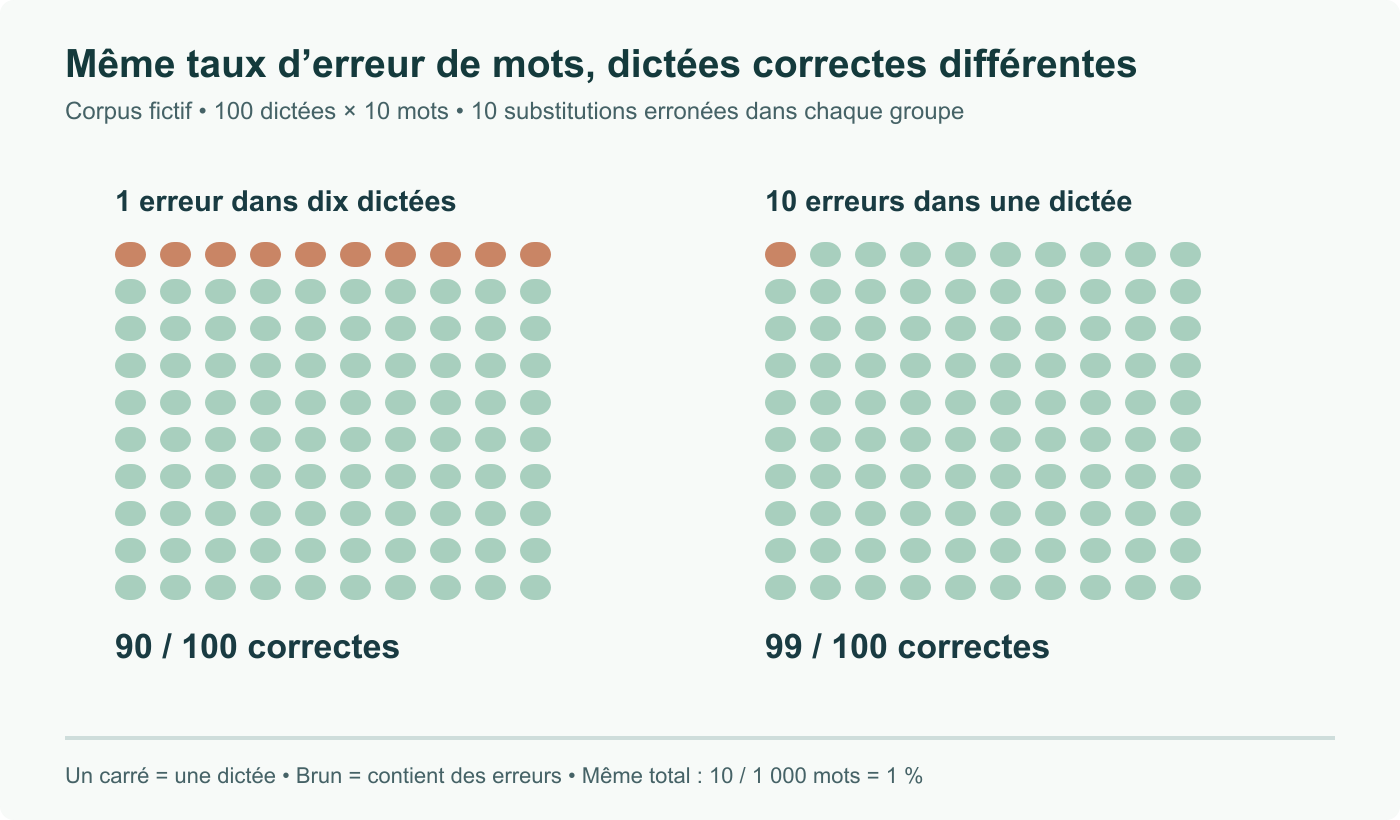
Prenons un corpus fictif original : 100 dictées de dix mots, soit 1 000 mots de référence. Supposons seulement dix erreurs de substitution. Les deux répartitions suivantes donnent un taux d’erreur de mots de 1 % :
| Répartition des dix erreurs | Dictées sans erreur |
|---|---|
| Une erreur dans chacune de dix dictées | 90 sur 100 |
| Dix erreurs concentrées dans une dictée | 99 sur 100 |
L’illustration montre ces répartitions. C’est un exemple arithmétique, pas un résultat Wispr. La moyenne des erreurs ne permet pas de retrouver la proportion de dictées correctes sans hypothèses supplémentaires. Le véritable taux sans retouche dépend aussi de ponctuation, mise en forme et intention du message, pas seulement de la correspondance des mots.
Une correction n’annule pas nécessairement tout le gain de temps de la dictée. Mesurez la durée totale, relecture et corrections comprises, plutôt que de supposer toute intervention plus lente que la frappe.
Tester le vrai microphone et le vocabulaire
Utilisez un ensemble fixe de messages ordinaires, noms, termes techniques et phrases multilingues, dans des conditions comparables. Relevez sorties à corriger, nature des erreurs et temps jusqu’au résultat acceptable. Examinez séparément les erreurs importantes : un nombre erroné peut compter davantage que plusieurs changements de ponctuation.
Le journal produit complète l’annonce. Le 21 août ajoute la sélection de microphones virtuels, notamment les entrées issues d’un traitement antibruit ; le 4 septembre ajoute le partage de dictionnaires par organisation ou département pour les comptes professionnels concernés. Consignez entrée choisie et dictionnaire, qui peuvent influencer le résultat indépendamment du modèle. Ces mises à jour ne prouvent pas, à elles seules, une date de déploiement universel de Canto.
Revue du 8 septembre : annonce vérifiée, affirmations corrigées et illustration explicative originale ajoutée.