Taalas spécialise le silicium pour un modèle. L’accord AMD inscrit cette approche dans ses projets ; un débit de génération ne définit pas la latence ni la qualité de toute l’application.
Accord et démonstration matérielle
L’annonce AMD du 6 août confirme un accord soumis aux conditions de clôture et autorisations réglementaires. L’intégration avec Instinct est prévue. Cela ne prouve pas qu’un produit AMD intégré soit livré.
Taalas présente HC1 comme un démonstrateur technologique exécutant Llama 3.1 8B, autour de 17 000 tokens/s par utilisateur selon ses mesures. Son explication technique décrit silicium spécialisé, contexte configurable et LoRA. Elle reconnaît aussi une dégradation de qualité liée aux paramètres HC1 en 3 et 6 bits. Cette réserve compte dans la comparaison des débits.
Calculer le délai réellement vécu
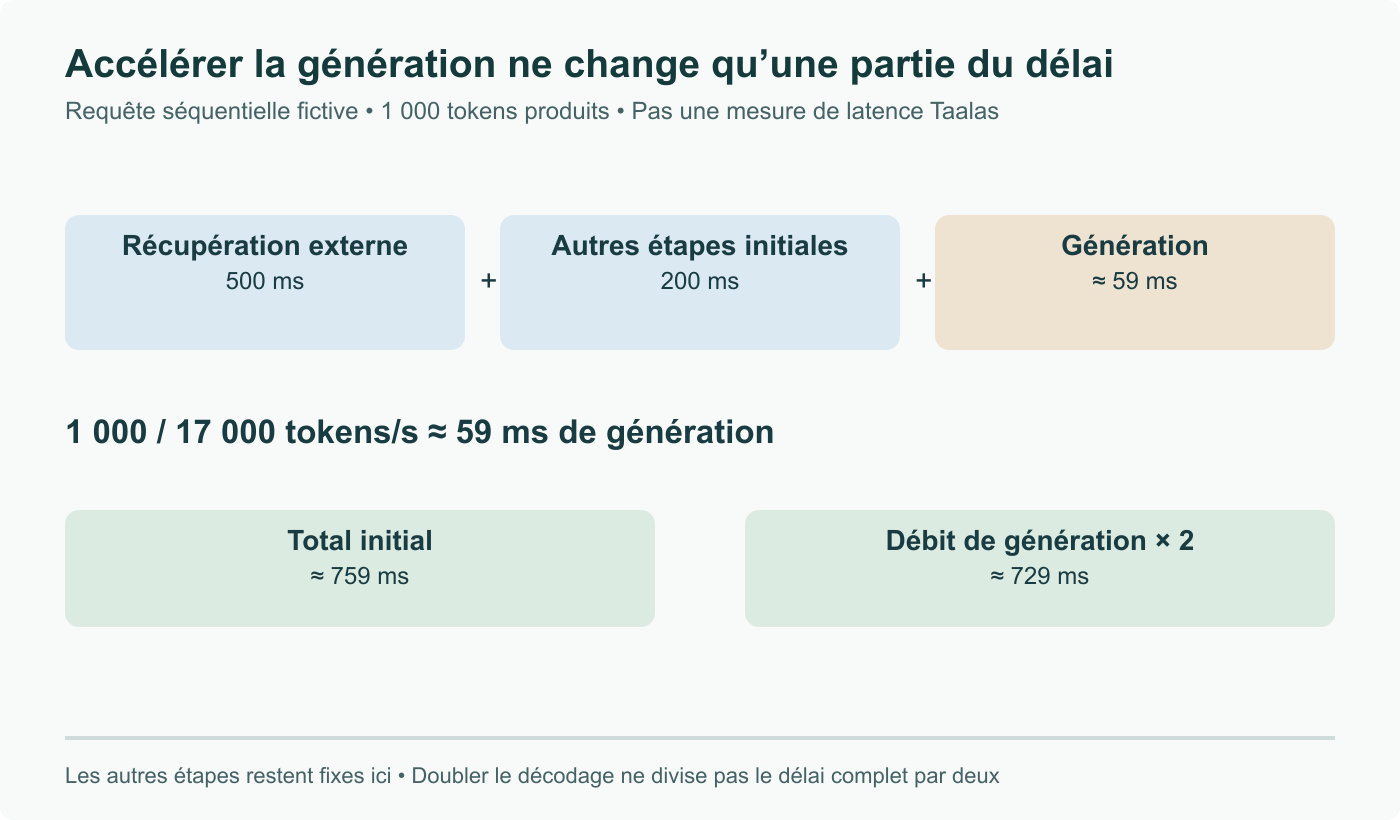
La couverture prend une requête fictive de 1 000 tokens de sortie à 17 000 tokens/s : environ 59 ms de génération. Ajoutons 200 ms hypothétiques avant génération et 500 ms de récupération externe : environ 759 ms au total dans ce modèle séquentiel simplifié.
Doubler le débit de génération économise alors environ 29 ms, pas la moitié du délai complet. Un service réel peut chevaucher les étapes, diffuser progressivement ou appeler plusieurs outils. Ce n’est pas une mesure HC1 : l’exemple explique pourquoi le débit de décodage ne remplace pas la décomposition de latence.
La spécialisation change les mises à jour
Un accélérateur programmable charge d’autres poids. Un matériel construit autour d’un modèle pose d’autres questions : quelles adaptations sont permises, lesquelles nécessitent du silicium neuf, et combien de temps ce modèle restera pertinent ? LoRA ne transforme pas chaque remplacement de modèle en mise à jour logicielle.
L’ancien article affirmait aussi que chaque token lit toujours tous les poids. C’est trop général : experts routés et traitement par lots modifient travail et trafic mémoire. Les limites du préremplissage et du décodage dépendent également de la charge et du matériel.
Pour comparer, fixez tâche et qualité attendue. Relevez premier token, débit de génération, utilisateurs simultanés et délai complet. La spécialisation peut être intéressante pour une tâche stable et fréquente ; la preuve doit porter sur cette tâche, pas uniquement sur son étape la plus rapide.
Revue du 8 septembre : accord de rachat distingué de sa clôture ; mesures HC1 et quantification attribuées ; exemple de latence complète ajouté.