OpenAI a publié les résultats d’inférence de Jalapeño le 25 août. Ils comparent latence et débit par kilowatt sur des modèles publics. La précision essentielle concerne le dénominateur : puissance nominale des accélérateurs, pas consommation mesurée du centre de données.
Ce qui a été comparé
Les résultats officiels portent sur GPT-OSS 120B, DeepSeek R1 et Kimi K2.5 face à des configurations GB200 ou GB300 précisées. OpenAI utilise les puissances nominales, dont 700 W pour Jalapeño. L’avantage annoncé de 1,5 à 1,9 fois au débit maximal doit garder cette base et son attribution au fabricant.
L’annonce initiale et la mise à jour d’août prévoient un déploiement d’ici fin 2026. Du matériel mesuré en essai et un service largement exploité en production constituent deux états différents.
La normalisation n’est pas une mesure à la prise
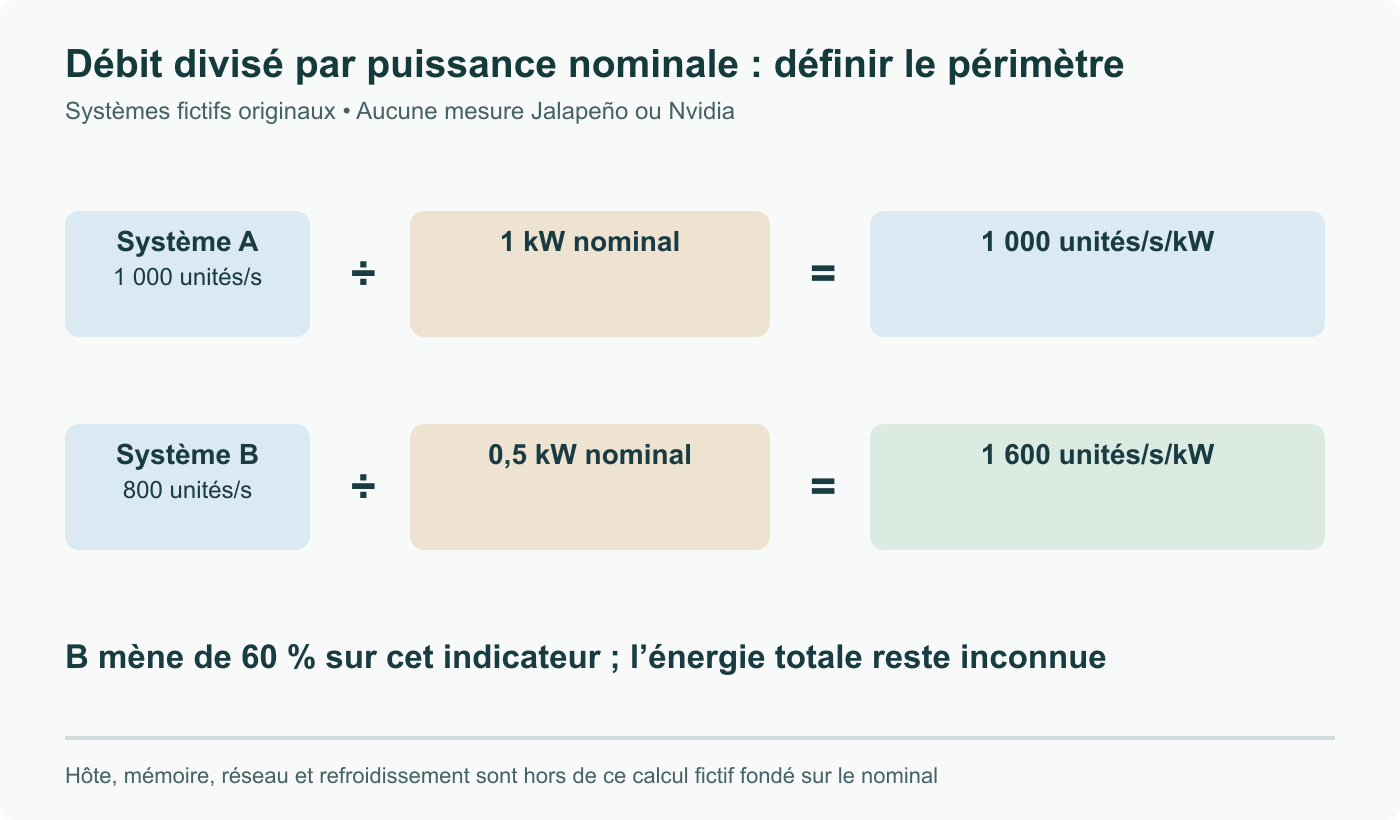
Prenons deux systèmes fictifs. A termine 1 000 unités de travail utile par seconde avec une puissance nominale d’accélérateur de 1 kW ; B en termine 800 avec 0,5 kW nominal. Les débits normalisés valent respectivement 1 000 et 1 600 unités/s/kW. B mène de 60 % sur cet indicateur.
Ce calcul ne donne pas l’électricité consommée par les systèmes entiers. Il exclut les contributions inconnues des processeurs hôtes, mémoire, réseau et refroidissement, et utilise des valeurs nominales. Remplacer la valeur de l’un par une mesure réelle tout en gardant le nominal de l’autre changerait asymétriquement la comparaison.
L’exemple explique le dénominateur ; ses valeurs ne mesurent ni Jalapeño ni Nvidia.
Garder l’objectif de latence avec le débit
Le débit maximal peut correspondre à une concurrence et une latence différentes de la réponse individuelle la plus rapide. Comparez les maxima entre eux, ou les deux systèmes sous une même exigence de latence. Prendre la meilleure latence d’un point et le meilleur débit d’un autre ne prouve pas qu’ils soient simultanés.
Pour une évaluation applicative, conservez modèle, précision, longueurs d’entrée et de sortie, concurrence, périmètre électrique et critère de fin. Un résultat sur un noyau logiciel sélectionné ne décrit pas non plus tout le modèle ; le billet d’août distingue explicitement ses optimisations de blocs.
PeopleAreGeek n’a pas reproduit ces mesures. La publication précise configurations, points de fonctionnement et méthode de normalisation. Ces conditions sont essentielles pour interpréter le résultat.
Revue du 8 septembre : sources primaires, portée des annonces et exemples vérifiés ; illustration remplacée.