La présentation Samsung à Hot Chips décrit LPDDR5X-PIM, avec du calcul près des banques DRAM. Les 614 Go/s annoncés concernent le chemin interne PIM. Ils ne décrivent pas une liaison classique de 614 Go/s entre la mémoire et le processeur.
Suivre l’emplacement du calcul
L’article technique de Samsung décrit un bloc PIM associé à chaque banque et une couche logicielle organisant données et exécution. Rapprocher le calcul des poids stockés peut éviter de les transporter sans cesse par l’interface mémoire externe.
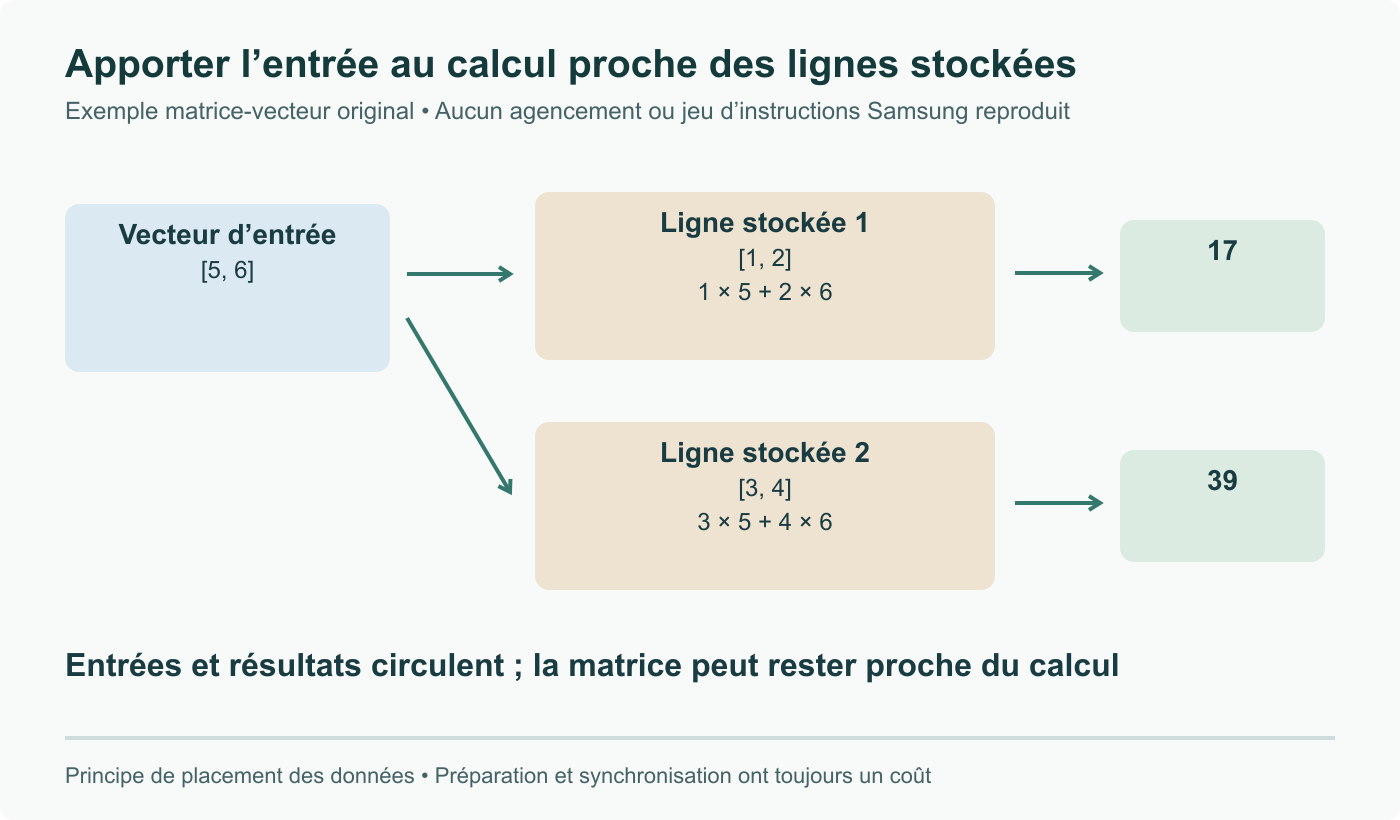
Dans un petit exemple original, les lignes stockées [1, 2] et [3, 4] multiplient l’entrée [5, 6]. Les résultats valent 17 et 39. Une organisation de type PIM peut apporter l’entrée au calcul proche des lignes et renvoyer ce résultat plus petit, au lieu de déplacer toute la matrice vers une unité de calcul éloignée pour cette opération.
L’exemple explique le placement, pas la séquence d’instructions exacte de Samsung ni ses précisions supportées. Entrées, sorties, préparation et synchronisation demandent encore transferts ou exécution : calculer en mémoire ne supprime pas toute communication.
La présentation donne plusieurs métriques
Les diapositives Samsung reproduites par ServeTheHome distinguent 76,8 Go/s pour la DRAM classique et environ 614 Go/s pour PIM dans la configuration indiquée. La démonstration sur silicium utilise Llama 3.1 8B avec des formats entiers et un contexte court, pas toute charge de tout modèle.
Le débit de sortie rapporté passe de 27,0 à 81,3 tokens/s, soit environ 3,01 fois. La durée indiquée séparément passe de 12,3 à 5,4 secondes, soit environ 2,28 fois. Ces ratios ne sont pas interchangeables ; aucun ne démontre une application huit fois plus rapide à partir du rapport de bande passante.
Logiciel et forme du travail restent déterminants
L’article antérieur est une étude par simulation. Ses résultats d’opérations matricielles ne doivent pas être présentés comme ceux de la démonstration sur silicium ultérieure. Il explique le rôle du placement et de la synchronisation : le découpage peut laisser des blocs inactifs, et le respect de l’ordre consommer une part du gain.
Une comparaison applicative utile conserve tâche, exigences numériques et politique de longueur de sortie, puis mesure l’exécution complète. Identifiez aussi ce qui reste sur l’hôte. La compatibilité avec un contrôleur mémoire ne signifie pas qu’une application inchangée émet automatiquement des opérations PIM.
PeopleAreGeek n’a pas testé cette mémoire. Le schéma est original ; les performances restent celles rapportées par Samsung, avec la source publique des diapositives pour consulter leurs conditions.
Revue du 8 septembre : sources primaires, portée des annonces et exemples vérifiés ; illustration remplacée.